EduSpark 上云实战复盘:从本地构建到服务器部署,把所有坑踩成文档
EduSpark 上云实战复盘:从本地构建到服务器部署,把所有坑踩成文档
蔚蓝WEILANXEduSpark 上云实战复盘:从本地构建到服务器部署,把所有坑踩成文档
本来以为是一次普通上线,结果硬是从镜像构建、网络加速、Compose 编排、环境变量注入、数据库初始化一路打到凌晨两点。
好消息是,坑基本都踩完了,坏消息是每个坑都很真实。
这篇就不讲大道理了,直接把这次 EduSpark(或者叫它 IdeaSpark)完整的上云链路和排障细节带血带肉地摊开写。你如果本地已经开发完,正准备把前后端容器化部署到服务器,这篇可以直接当作避雷手册。
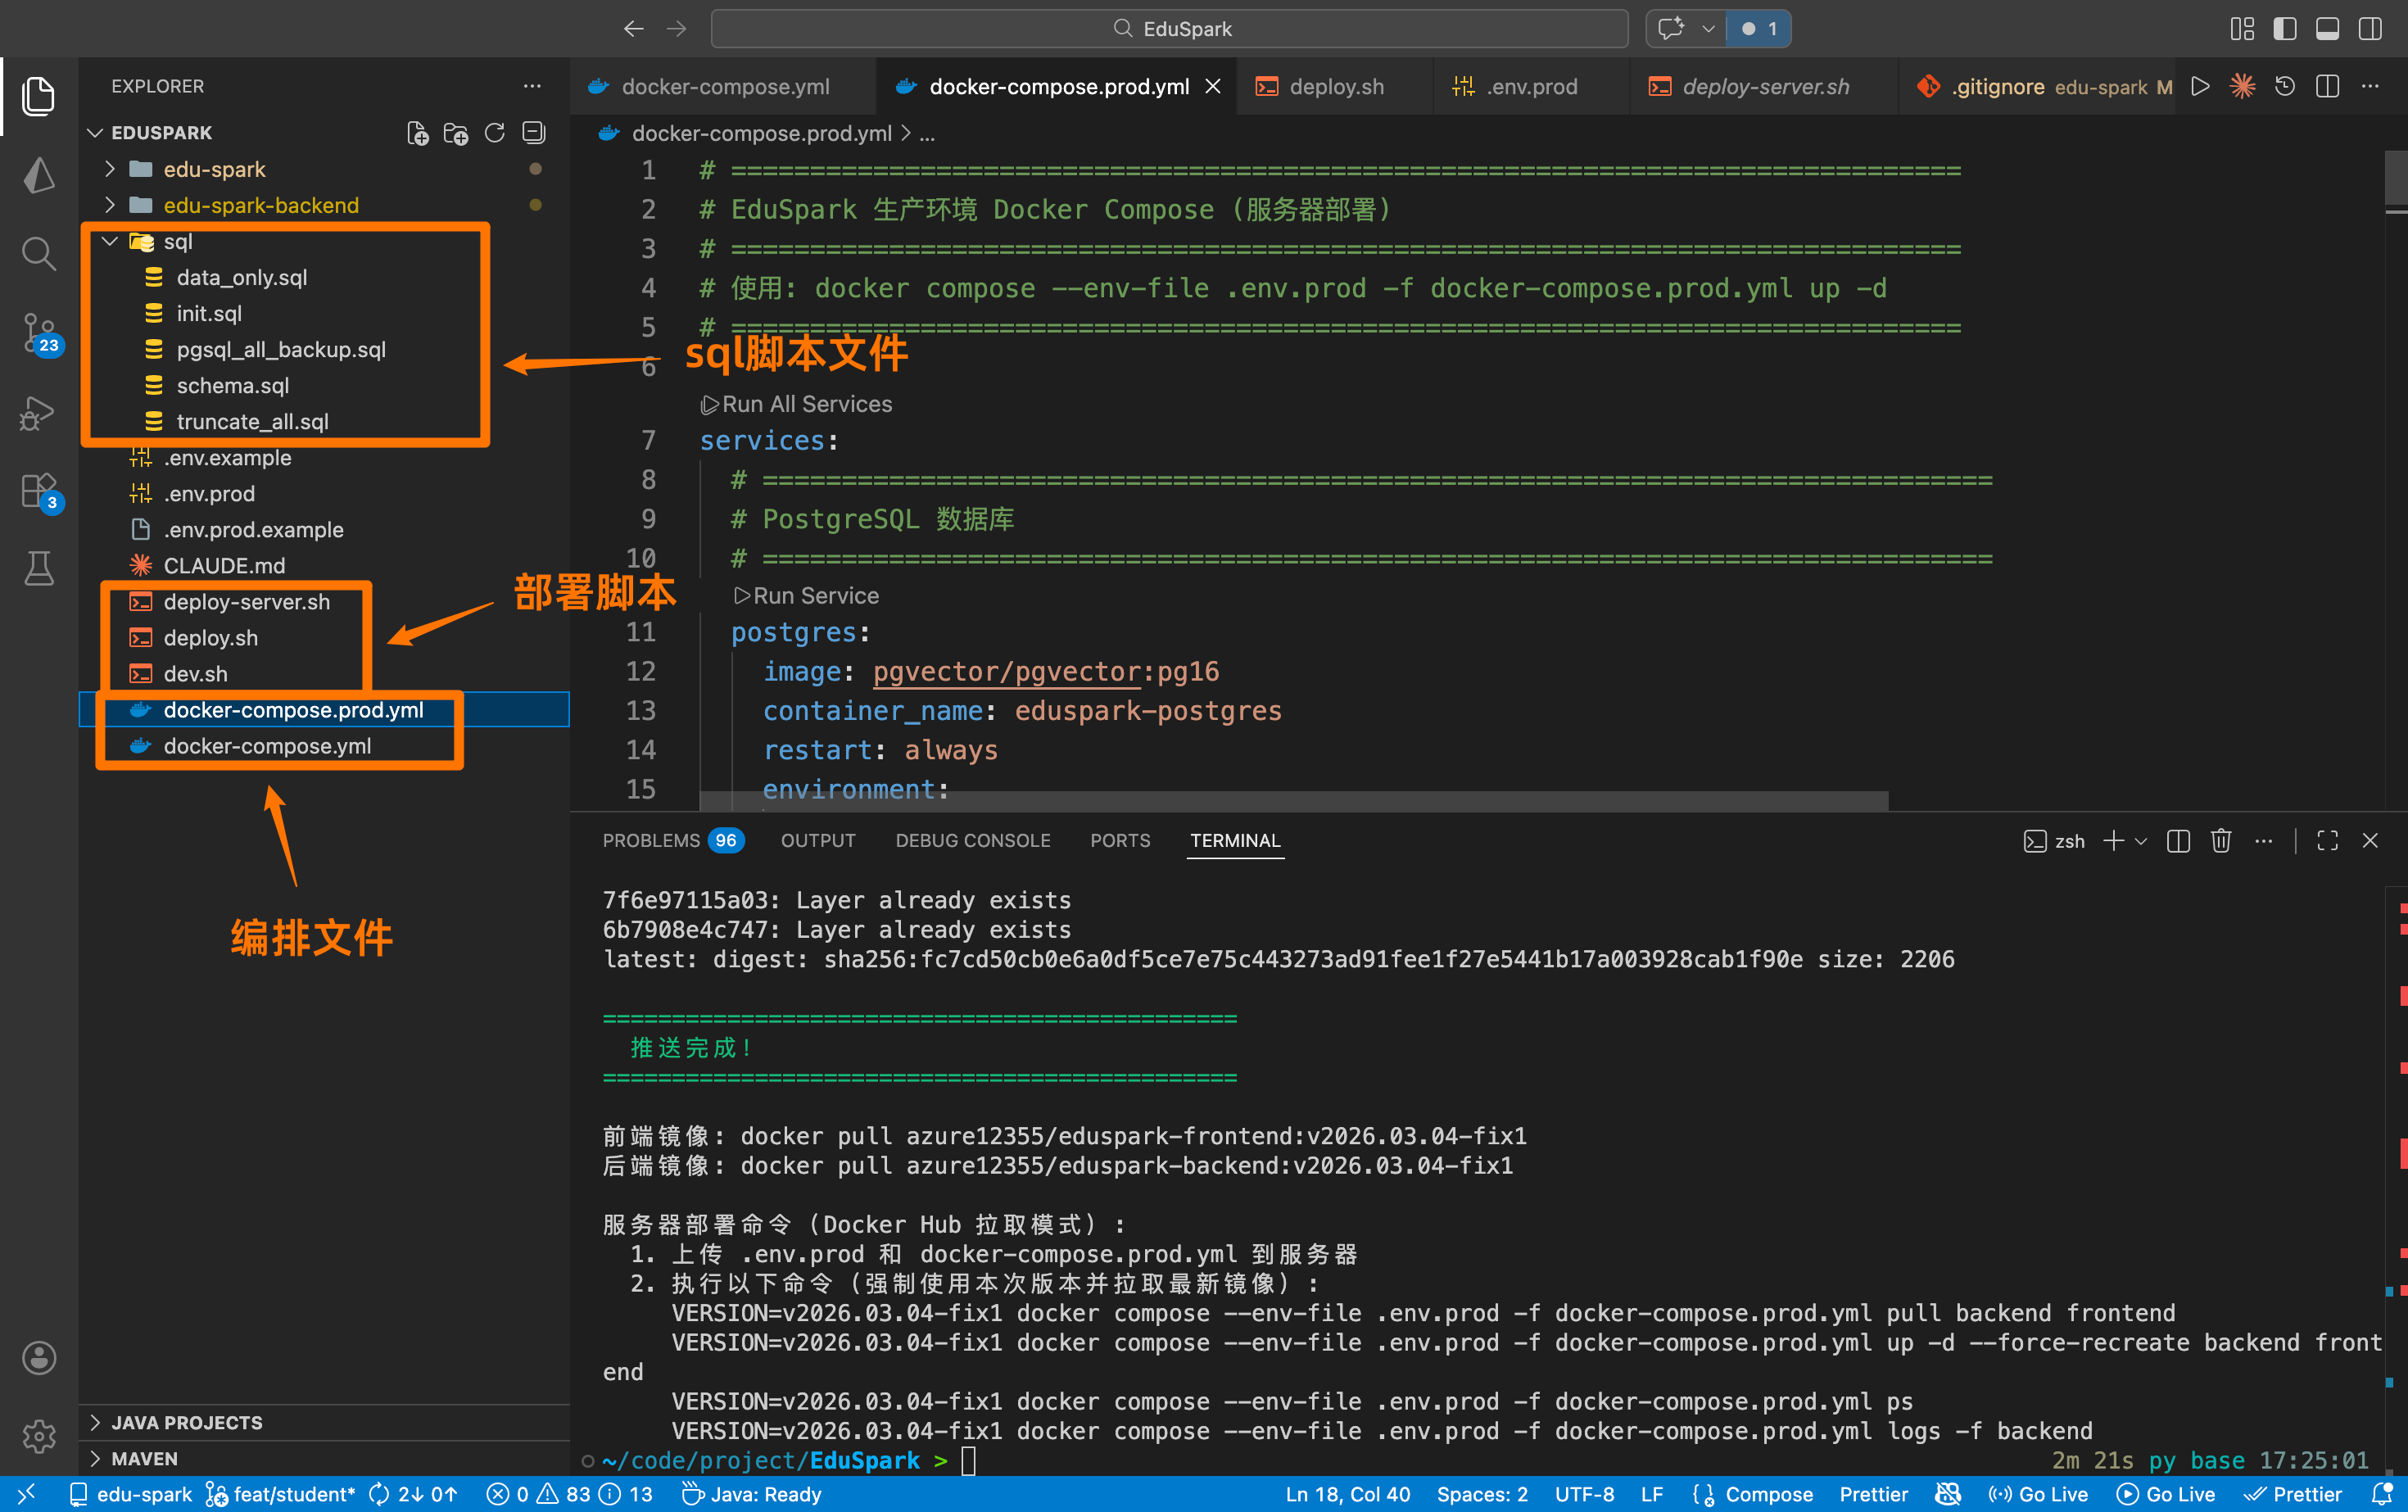
本地仓库目录总览(
deploy.sh、deploy-server.sh、docker-compose.prod.yml、sql/)
0. 这次部署的目标
项目形态:
- 前端:Next.js
- 后端:Spring Boot 3.4
- 基础设施:PostgreSQL 16 (pgvector) + Redis 7
预期链路:
- 本地构建
linux/amd64镜像(跨平台构建)。 - 推送到 Docker Hub,带上不可变 Version Tag。
- 服务器执行
deploy-server.sh自动化拉取并编排。 - 数据库初始化:结构自动,数据手动(这个结论是最后用命换来的)。
1. 构建镜像:先别急着 docker build
1.1 前端:别让“打包期”坑了“运行时”
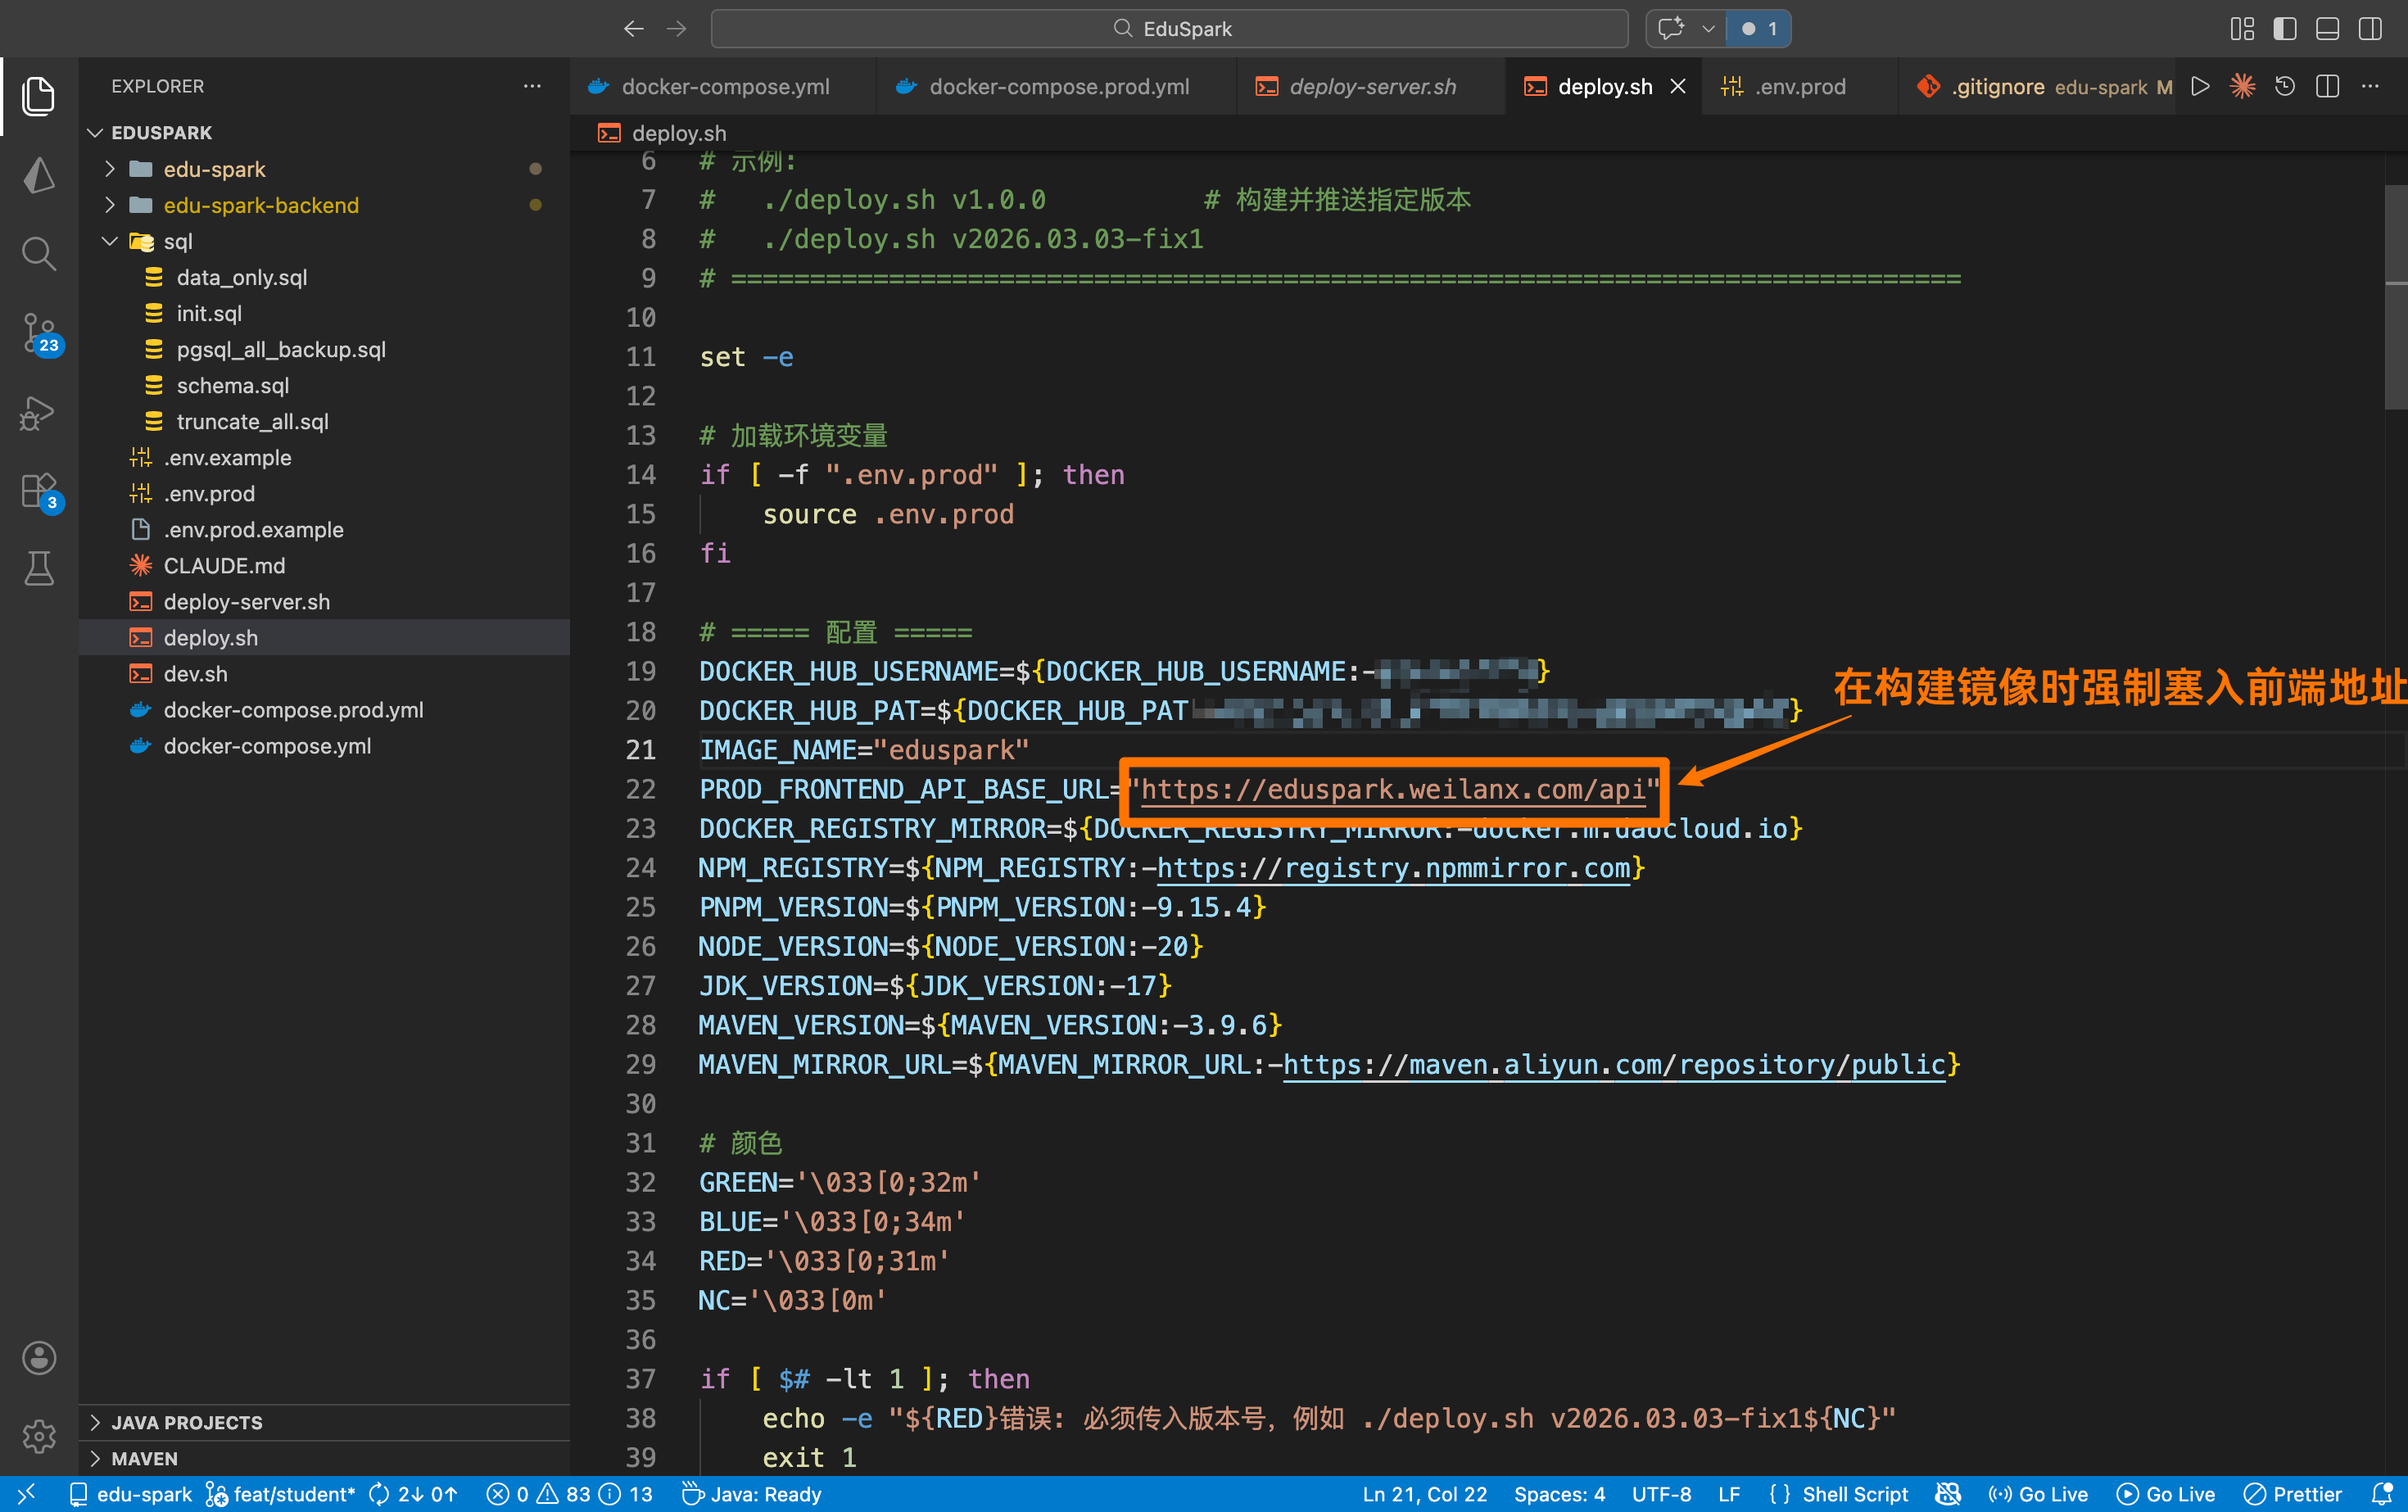
前端 Next.js 构建里最阴险的是 NEXT_PUBLIC_ 开头的环境变量。
- 坑点:这些变量是在 Build 阶段 注入到静态文件里的。如果你不在
docker build时传入NEXT_PUBLIC_API_BASE_URL,线上环境就会出现“页面能打开,但所有接口都报 404/undefined”的经典事故。 - 解决:在 Dockerfile 里接收
ARG并传给ENV。
1.2 后端:Spring Boot 的配置地雷
后端多阶段构建时,遇到了两个意想不到的“配置杀手”:
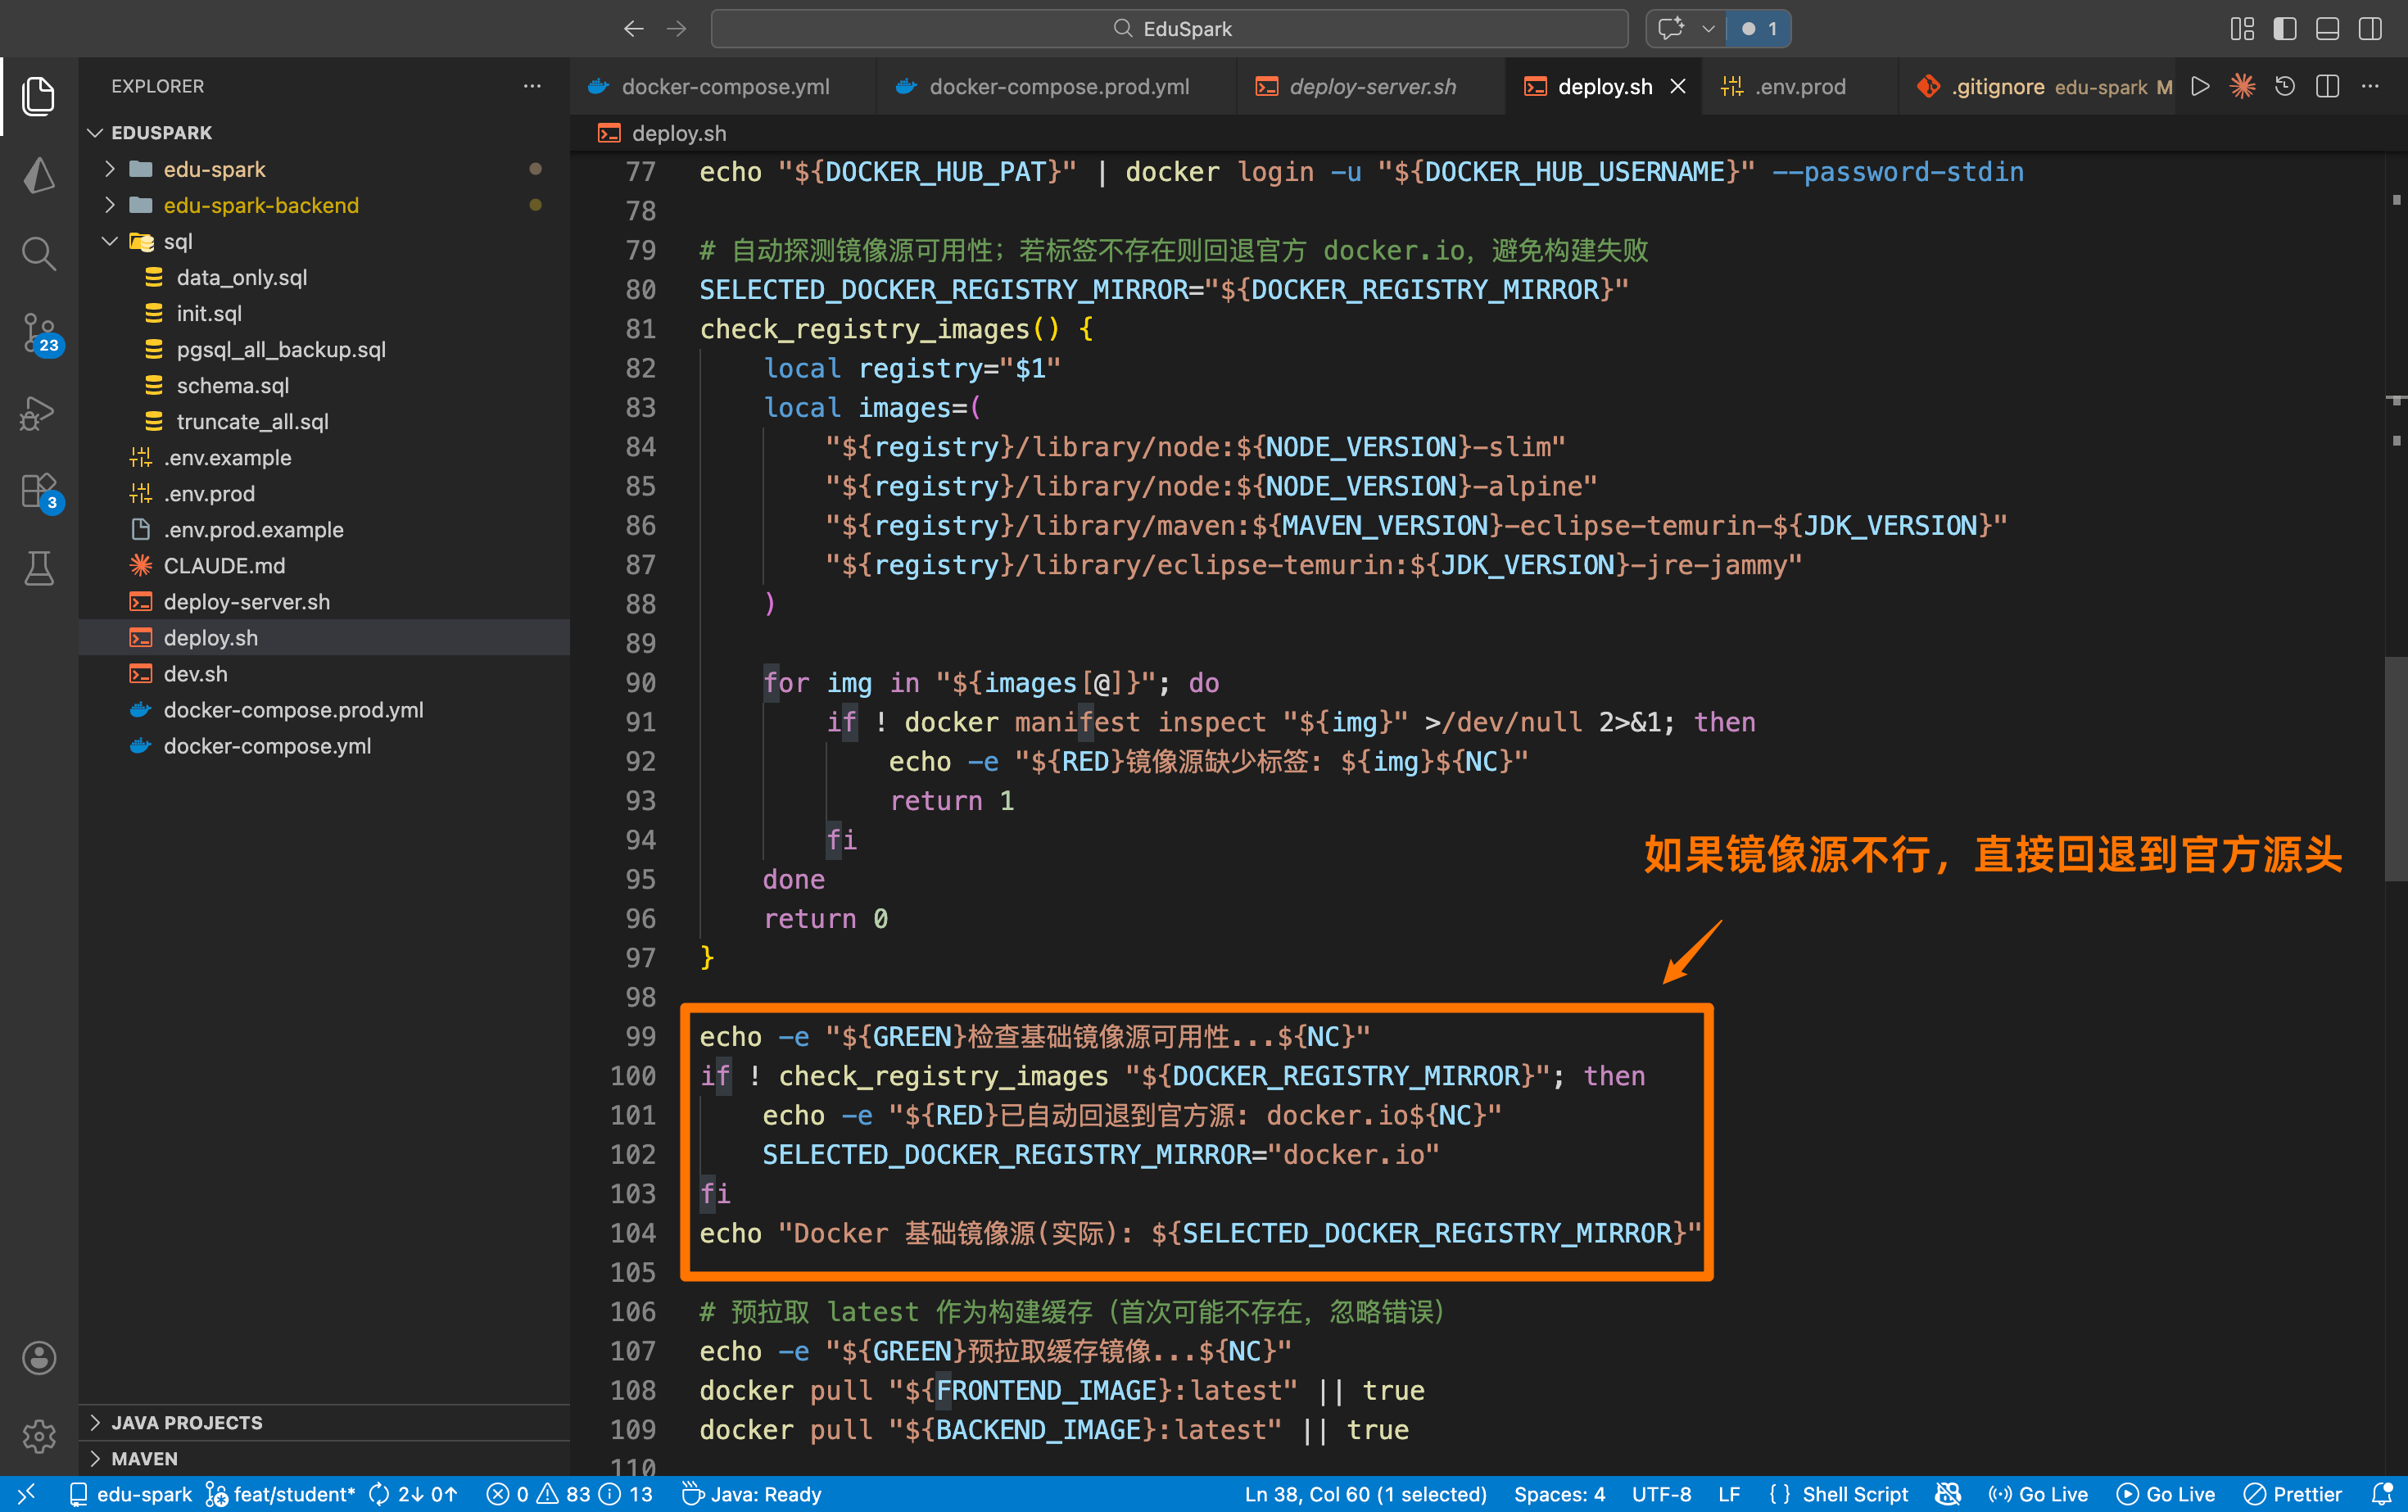
- 基础镜像 Tag 不存在:
- 报错:
maven:3.9.9-eclipse-temurin-17-jammy: not found。 - 调查:某些国内加速源并不保证全量 Tag 镜像,导致镜像拉取失败。
- 修复:回归到稳健的
3.9.6-eclipse-temurin-17,并在脚本里加了fallback机制。
- 报错:
(https://eo.cos.weilanx.com/blog-static/assets/posts/ifDZ/image-8c83d01f67b862a4.png)
- Spring Profile 循环陷阱:
- 报错:
InvalidConfigDataPropertyException: Property 'spring.profiles.active' ... is invalid in a profile specific resource。 - 原因:我在
application-prod.yml里自作聪明地又定义了一遍active: prod。在 Spring Boot 新版本里,Profile 特化文件不能再定义生效的 Profile,会引起冲突。 - 解决:在 Docker Compose 环境里统一通过
SPRING_PROFILES_ACTIVE=prod注入。
- 报错:
2. 构建慢:不是你电脑慢,是网络路径慢
这是最折磨人的环节。
pnpm install只有 19KiB/s,下载一个 tarball 都要等半天。- Maven 依赖下载遇到
Unknown host maven.aliyun.com(DNS 抖动)。
我的优化方案:
- NPM:强行切到
https://registry.npmmirror.com。 - Maven:使用阿里云公共仓库,并检查服务器 DNS 稳定性(
/etc/resolv.conf改为8.8.8.8)。 - Docker:本地提前拉取
latest镜像作为--cache-from,减少层下载量。
3. 环境变量注入:这就是隐形的“地雷”
我们遇到过大量这种告警:
DB_PASSWORD variable is not setVERSION variable is not set
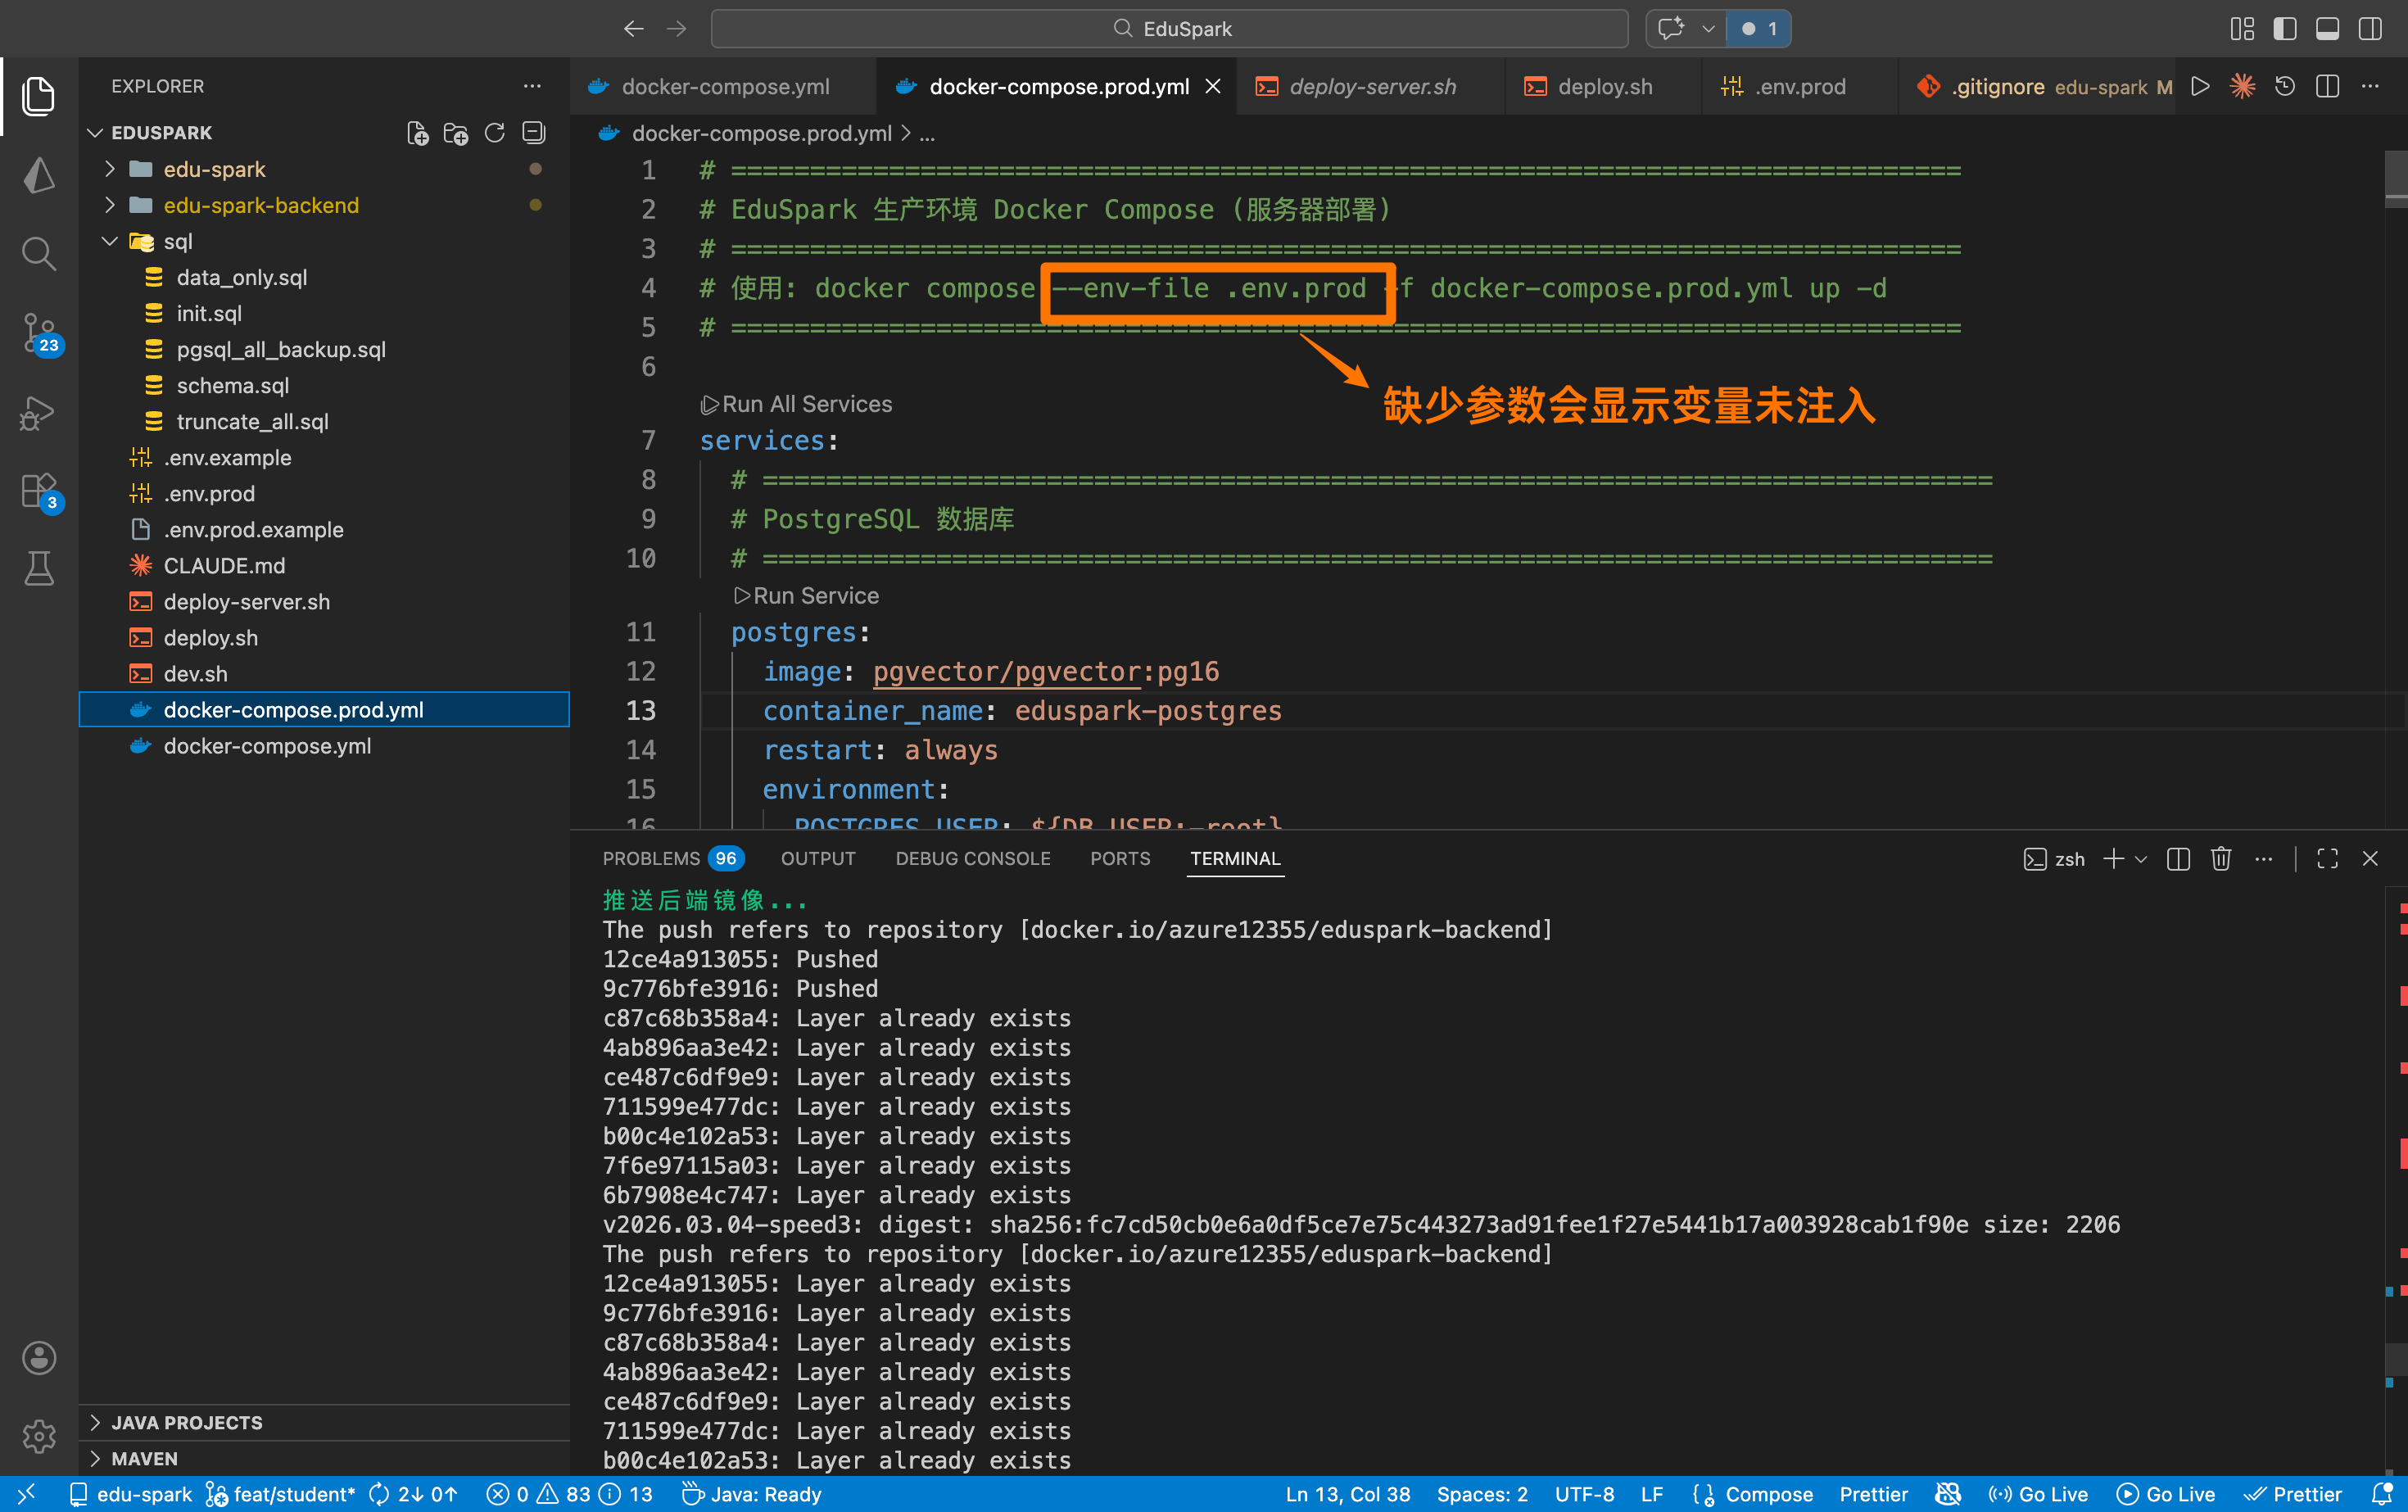
教训:别指望 .env 文件会自动在所有场景生效。
在生产环境,必须显式指定:
1 | docker compose --env-file .env.prod -f docker-compose.prod.yml up -d |
而且要记住:环境变量不统一,后面全是连锁反应。 AI key、数据库凭据、版本号,任何一个环节缺了,排错都要排半天。
4. Docker Compose 编排:跑起来才知道哪里错
4.1 致命点:db-init 成了“局外人”
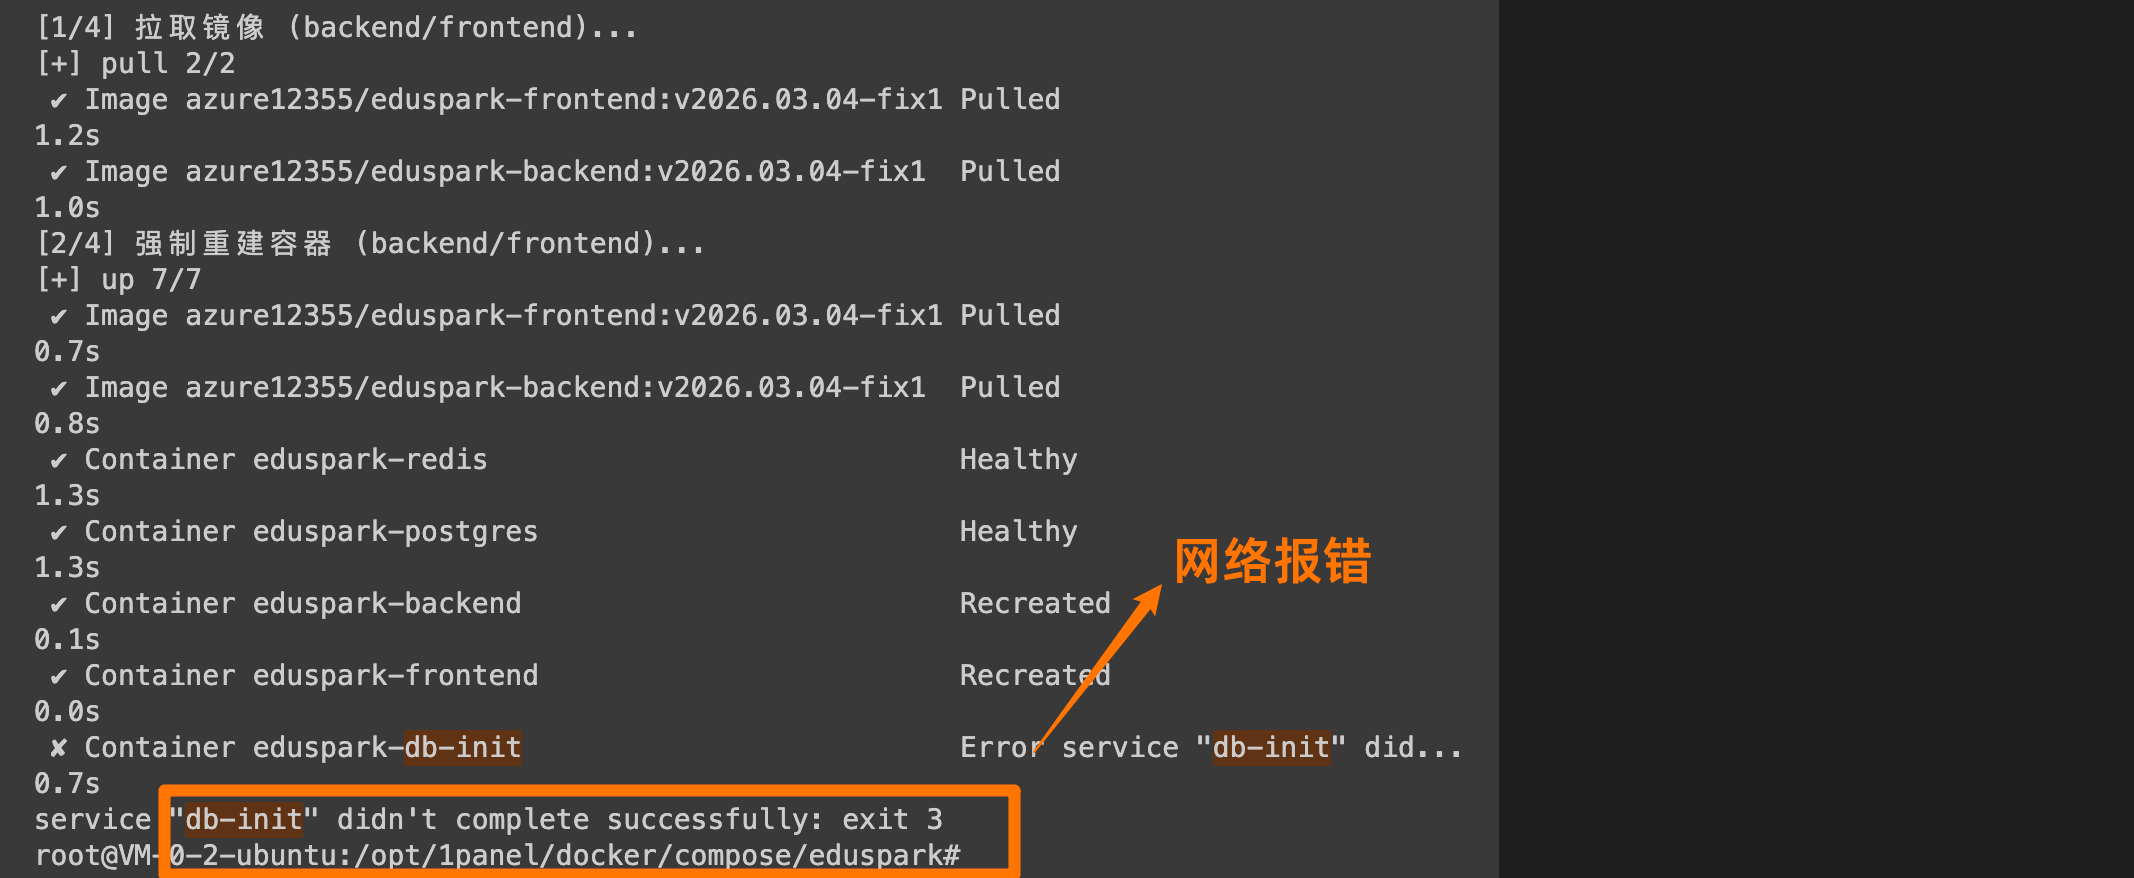
- 现象:
psql: could not translate host name "postgres"。 - 原因:我在 Compose 里把
postgres挂在了自定义网桥上,但db-init容器没加进去。它们名字虽然对,但在 Docker DNS 里根本不相往来。 - 修复:明确所有基础设施和初始化容器都在同一个
eduspark-network下。
4.2 错误被“掩盖”
一开始脚本里用了 || true,导致 SQL 导入失败了还打印“Success”。
修正:全流程 set -e,且 psql -v ON_ERROR_STOP=1。哪怕少一个表没建成功,整个部署直接报错退出,不带隐患。
5. 数据库脚本:跌宕起伏的初始化
5.1 init.sql 损坏
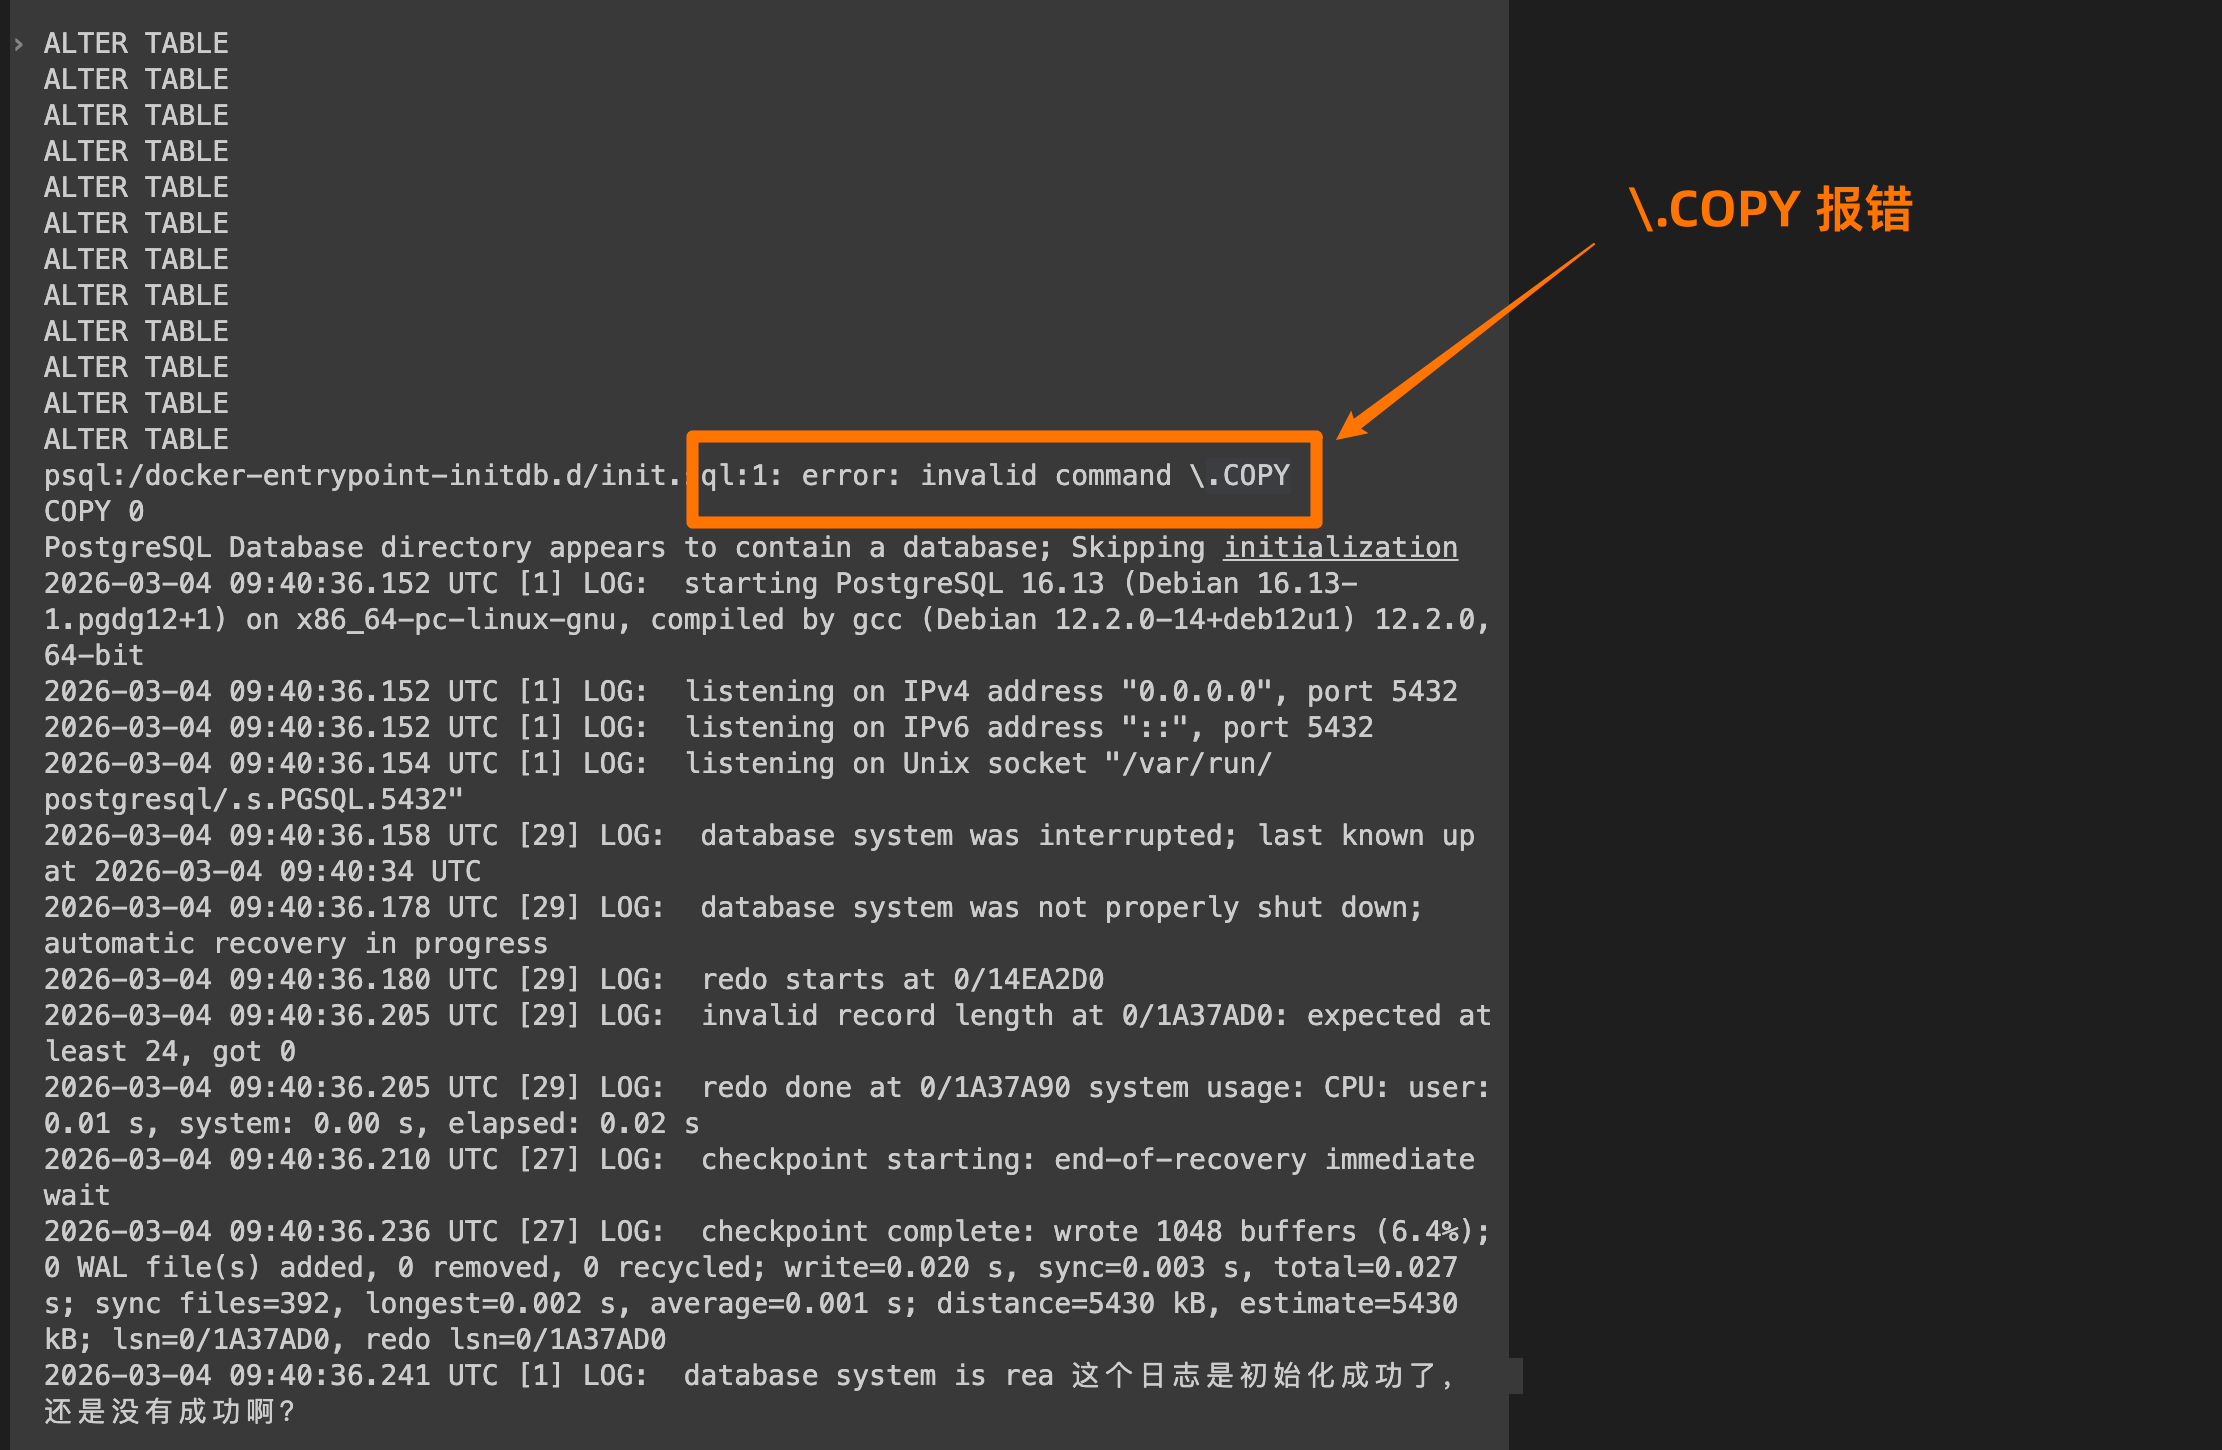
- 报错:
invalid command \.COPY。 - 原因:文件被搞烂了,
COPY FROM STDIN的终止符变成了乱码,导致 PG 认为剩下的几万行都是无效命令。
5.2 版本向下不兼容
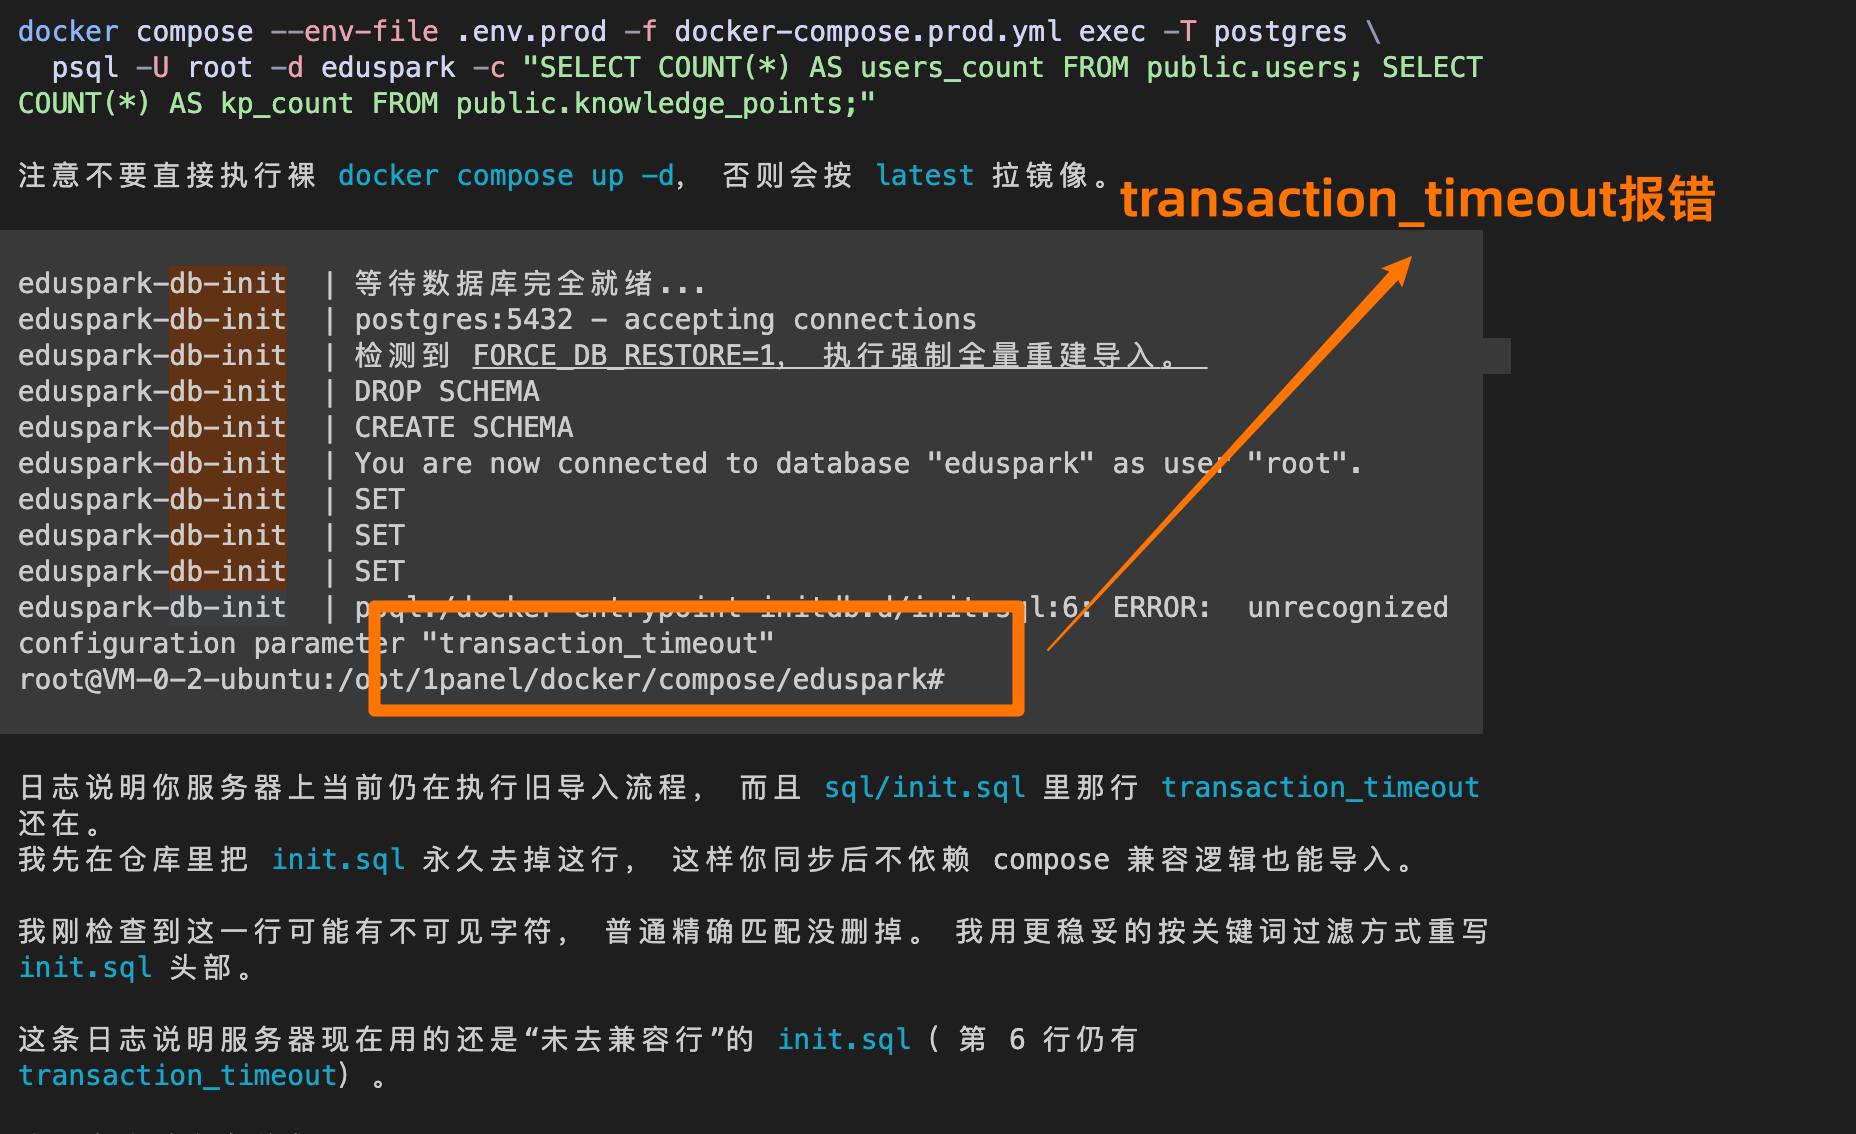
- 报错:
unrecognized configuration parameter "transaction_timeout"。 - 原因:我是用 PG17 导出的备份,但运行环境是 PG16。高版本的配置参数在低版本里直接报 Illegal。
- 解决:在导入前手动用
sed删掉这行,或者干脆用低版本做导出。
5.3 核心结论:解耦!解耦!再解耦!
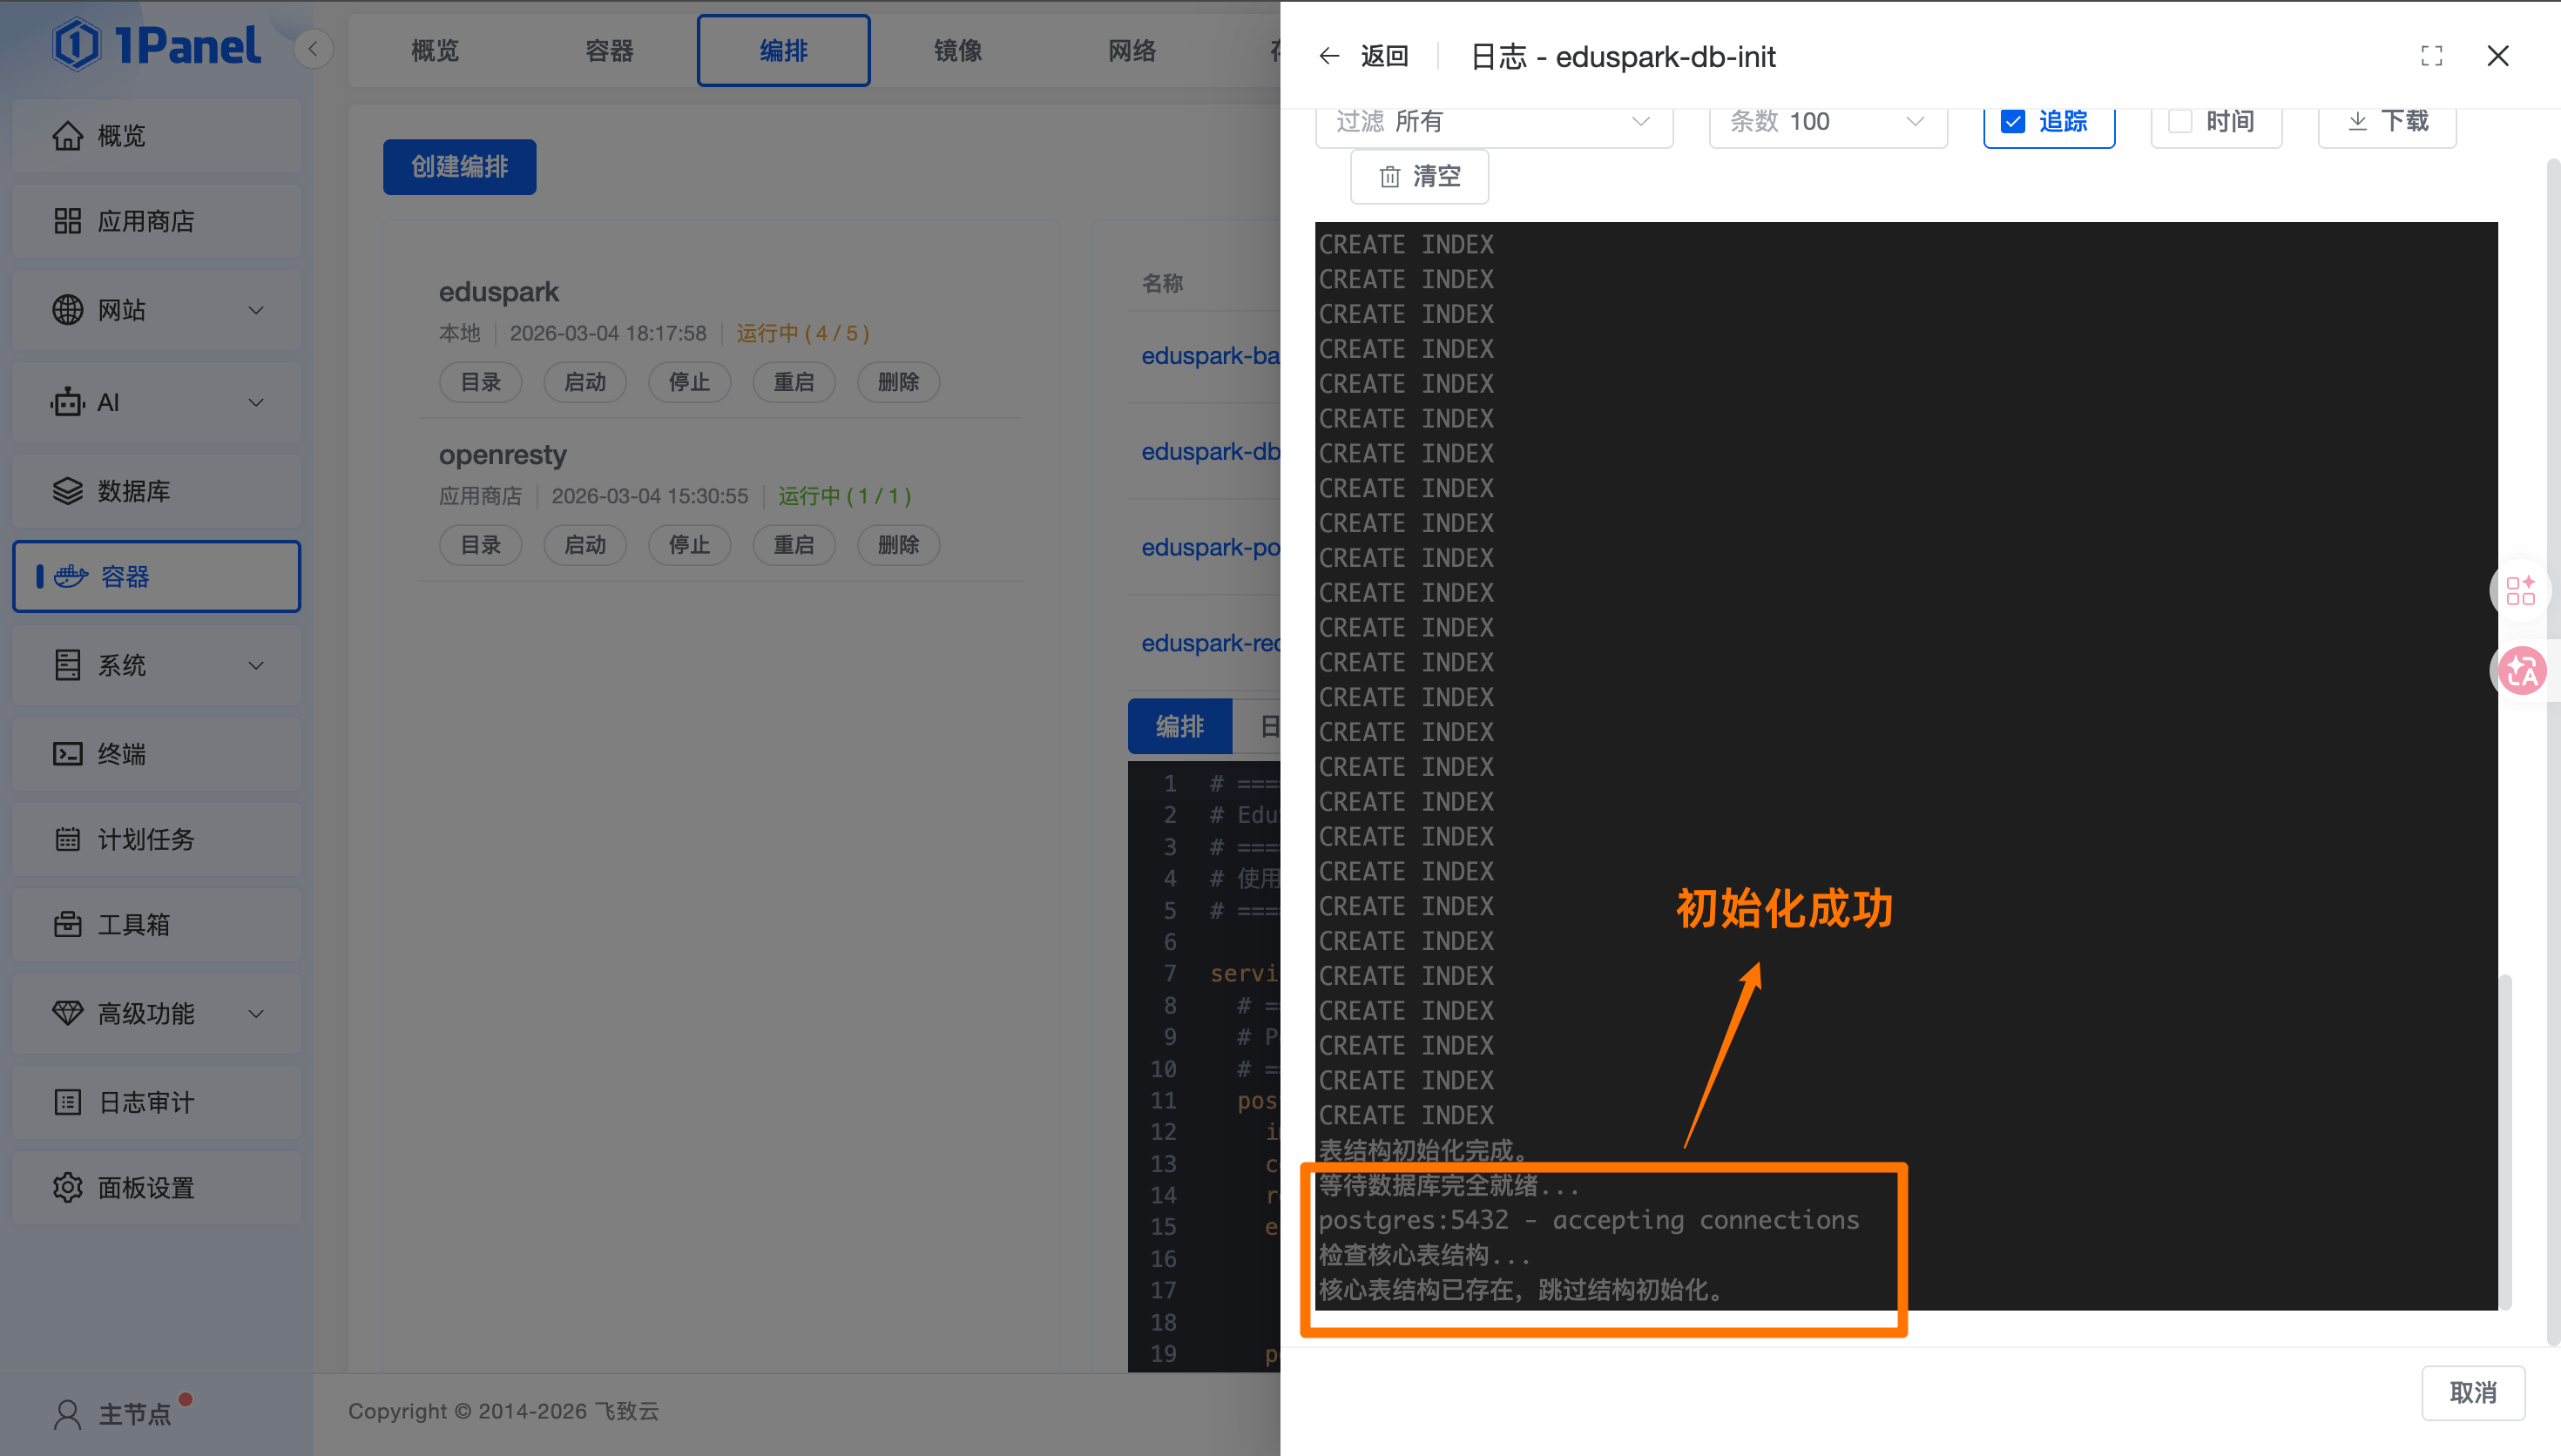
最后我决定:
- 结构自动:
schema.sql这种建表脚本放在容器启动流程里。 - 数据恢复手动档:几百 MB 的
data_only.sql别绑死在服务启动上。手动执行truncate再独立导入,才是上云该有的“可重复”品位。
6. 发布流程的最终形态
6.1 deploy.sh(本地)
构建 -> 打 Tag -> 推送。
不要裸用 latest,每次发布必须有一个时间戳或 Git Commit 相关的 Tag。
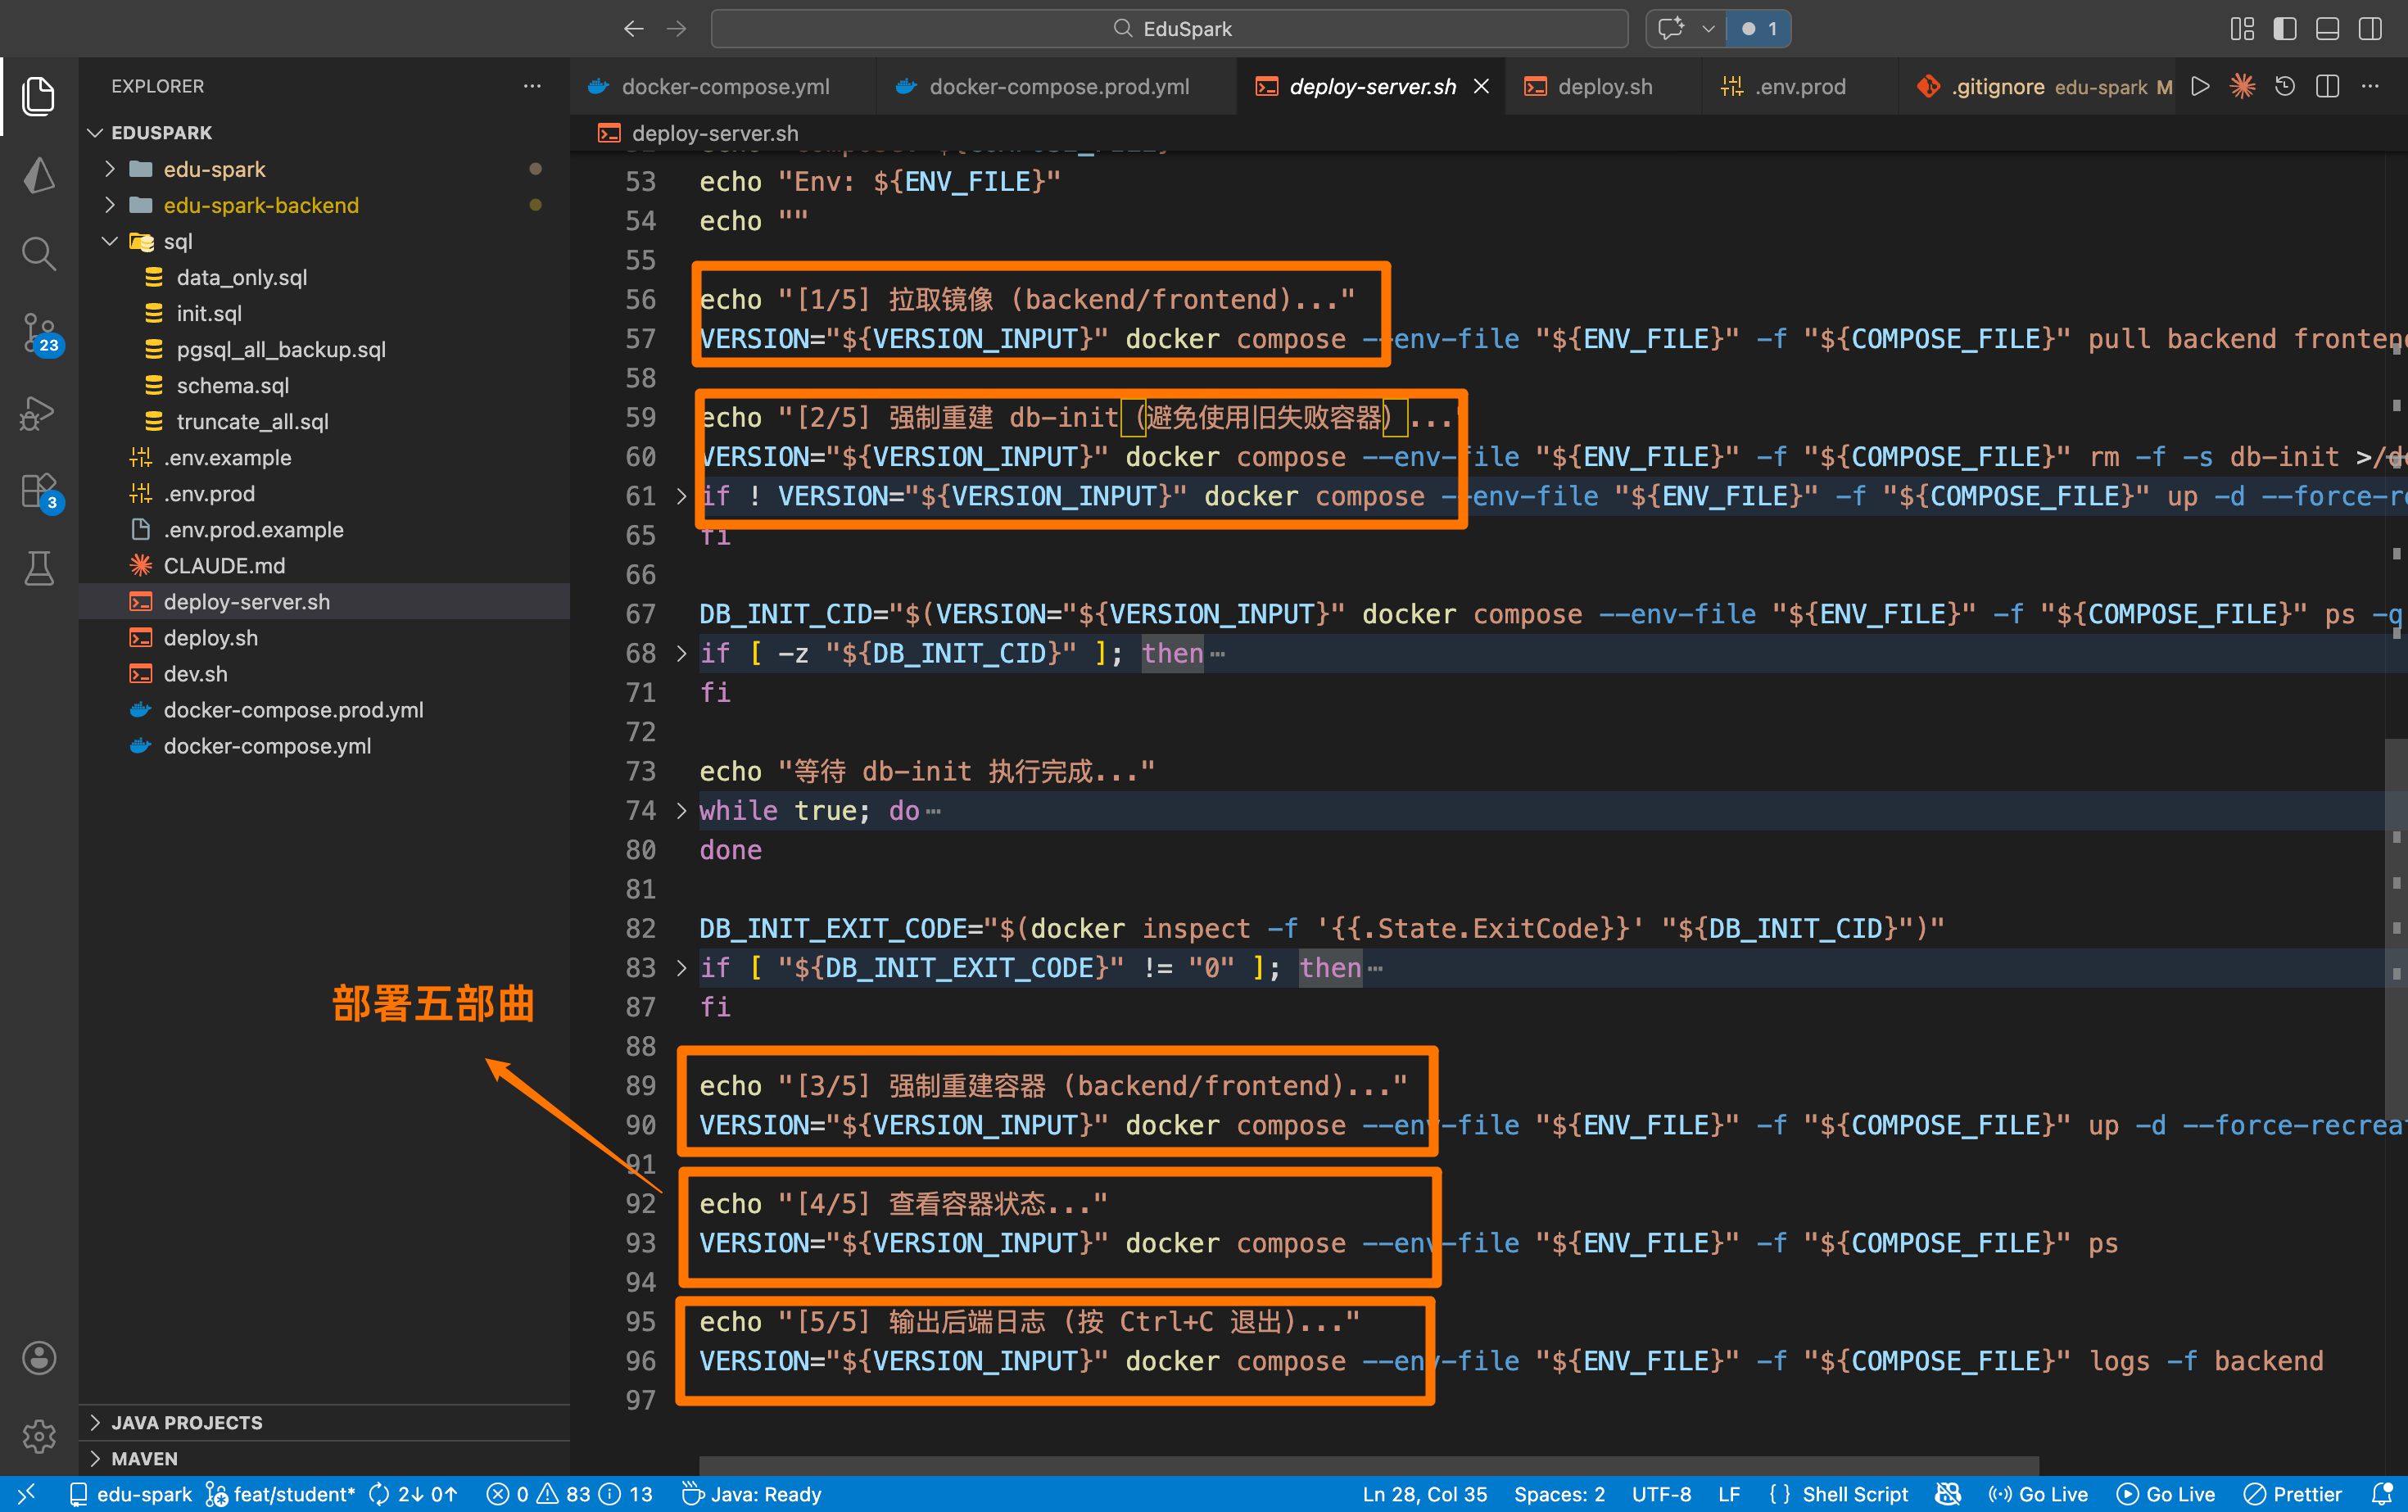
6.2 deploy-server.sh(服务器)
拉取 -> 显式重建 init 容器 -> 检查退出码 -> 拉起后端。
7. 在线上最容易手划的细节
- 命令换行截断:复制粘贴时少了最后一行,报错
--force-recreate: command not found,让你怀疑人生。 - 版本漂移:不带版本号执行
up -d,结果拉了错误的远程镜像,最后发现线上版本不对。 - 残留容器:如果不
rm -f旧的失败容器,up命令可能根本不会应用你新修改的内容。
8. 写在最后
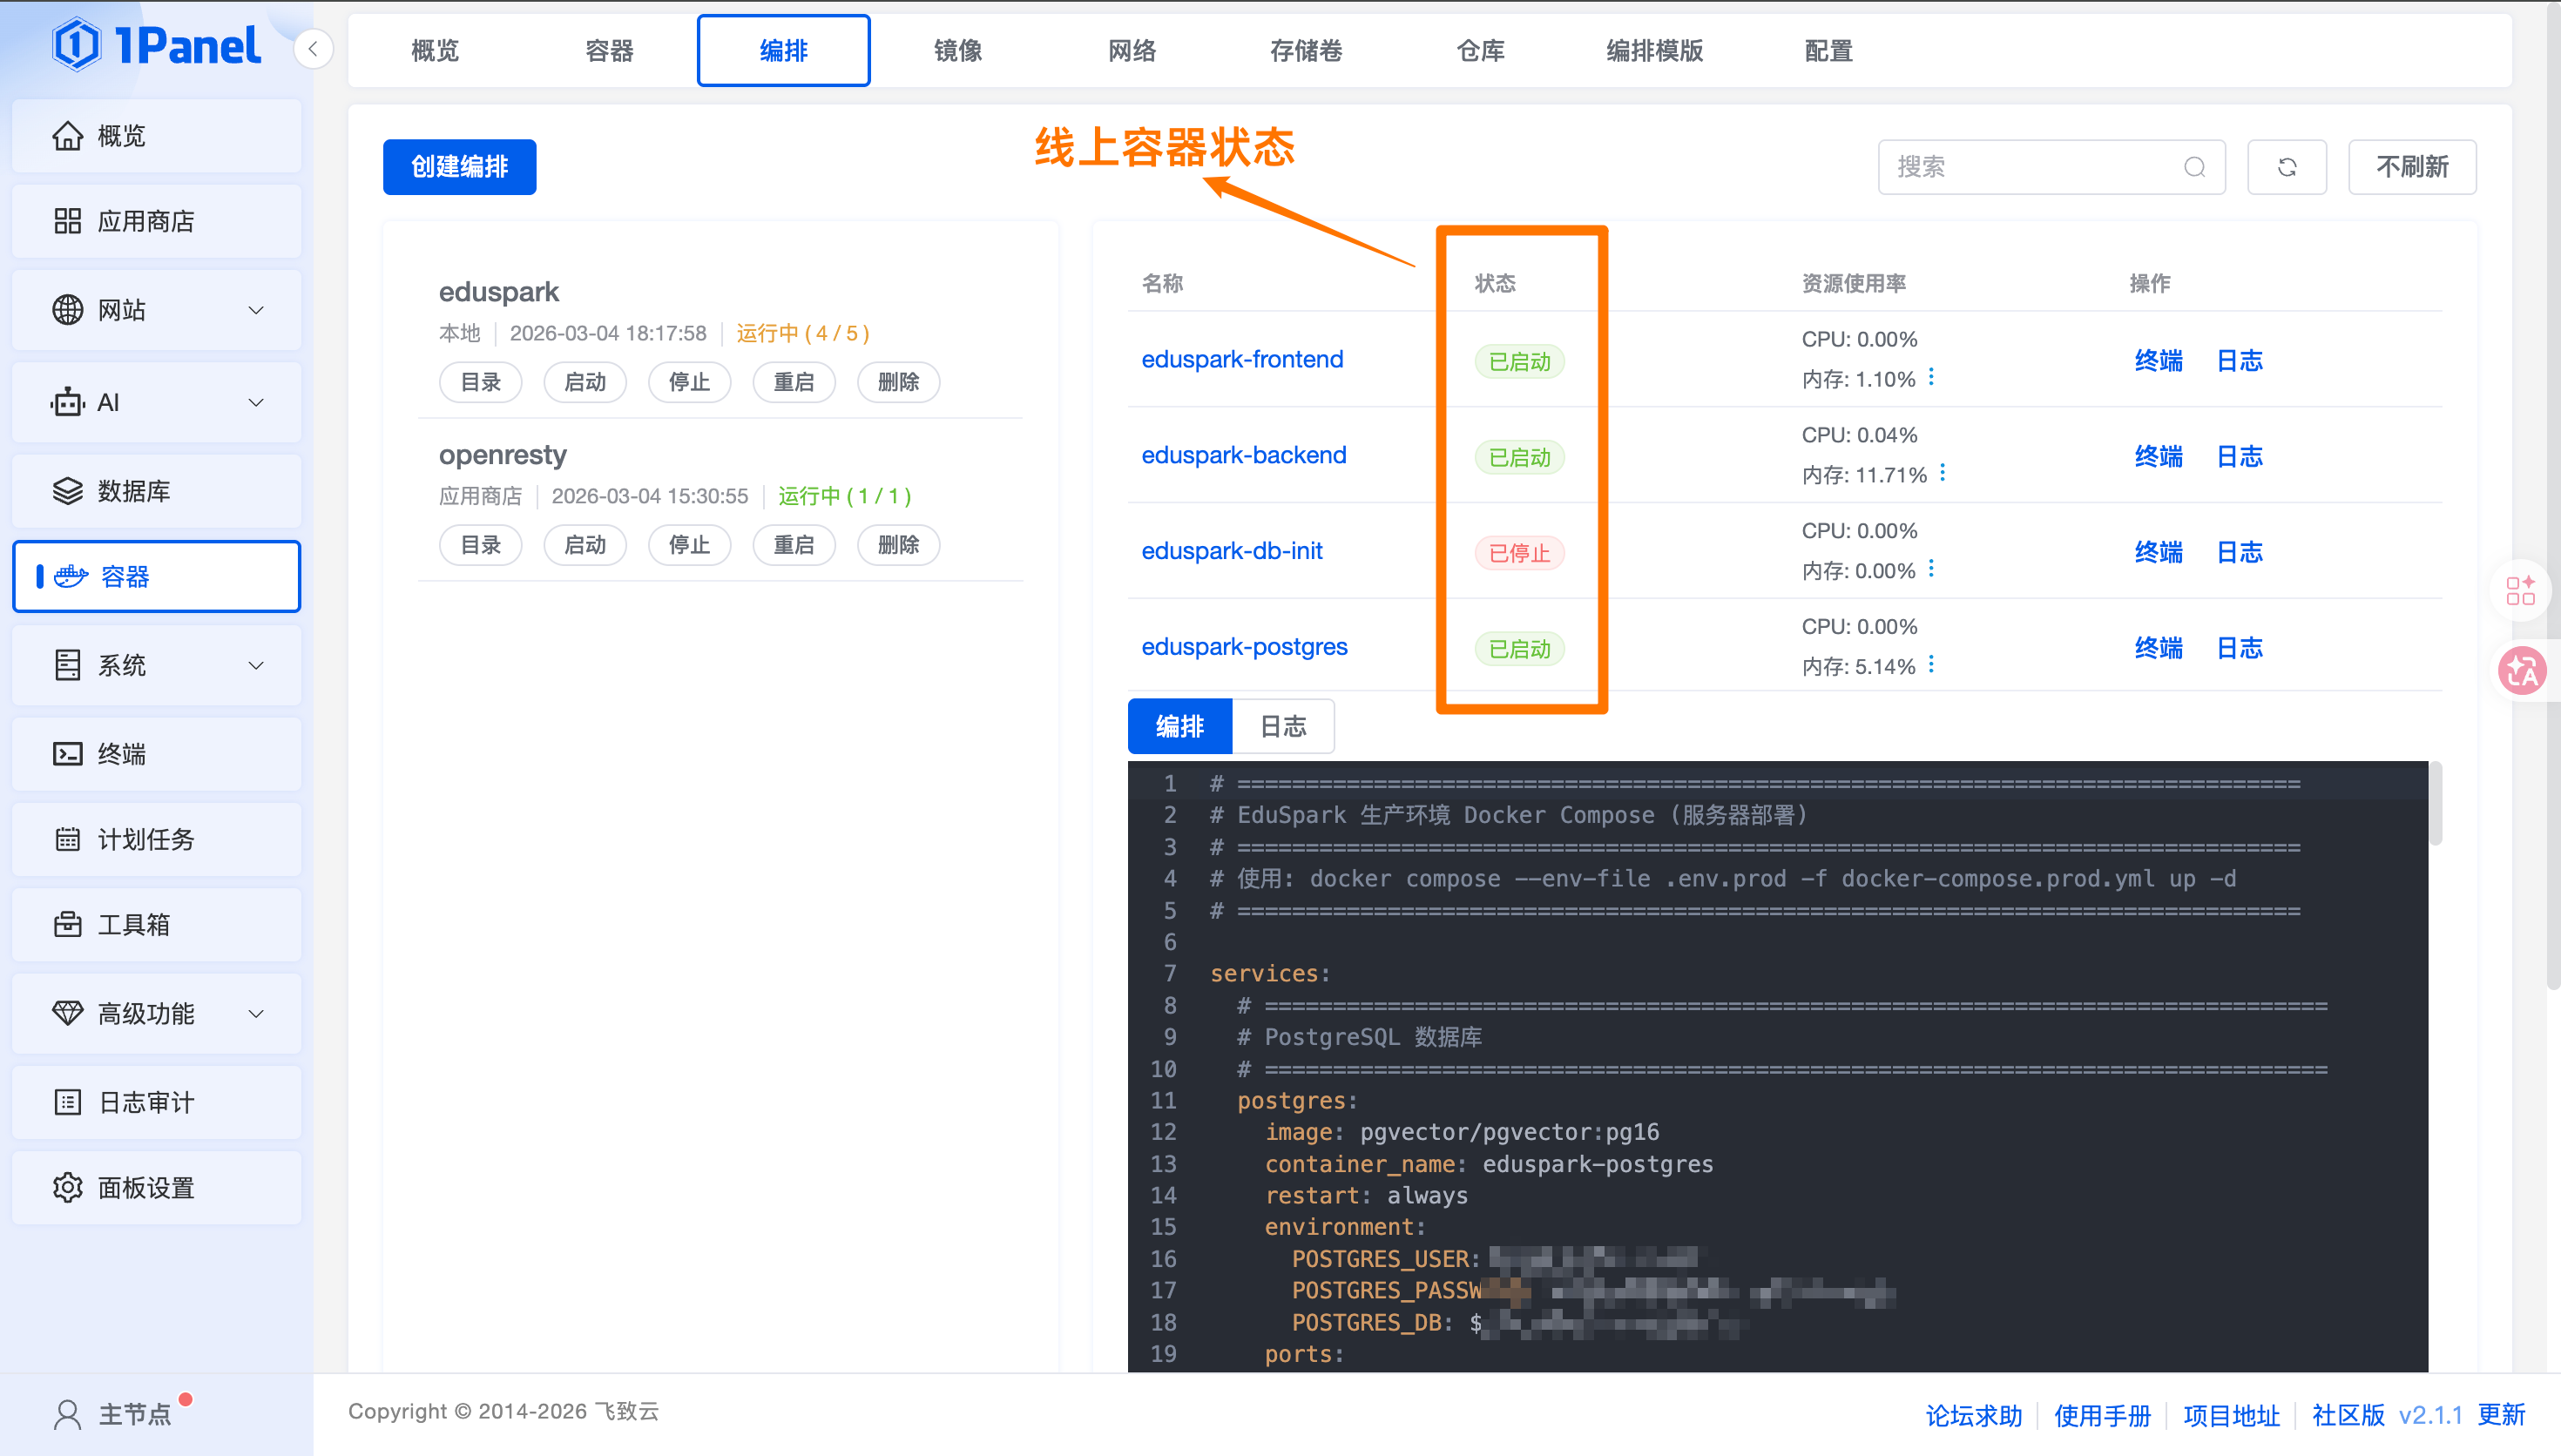
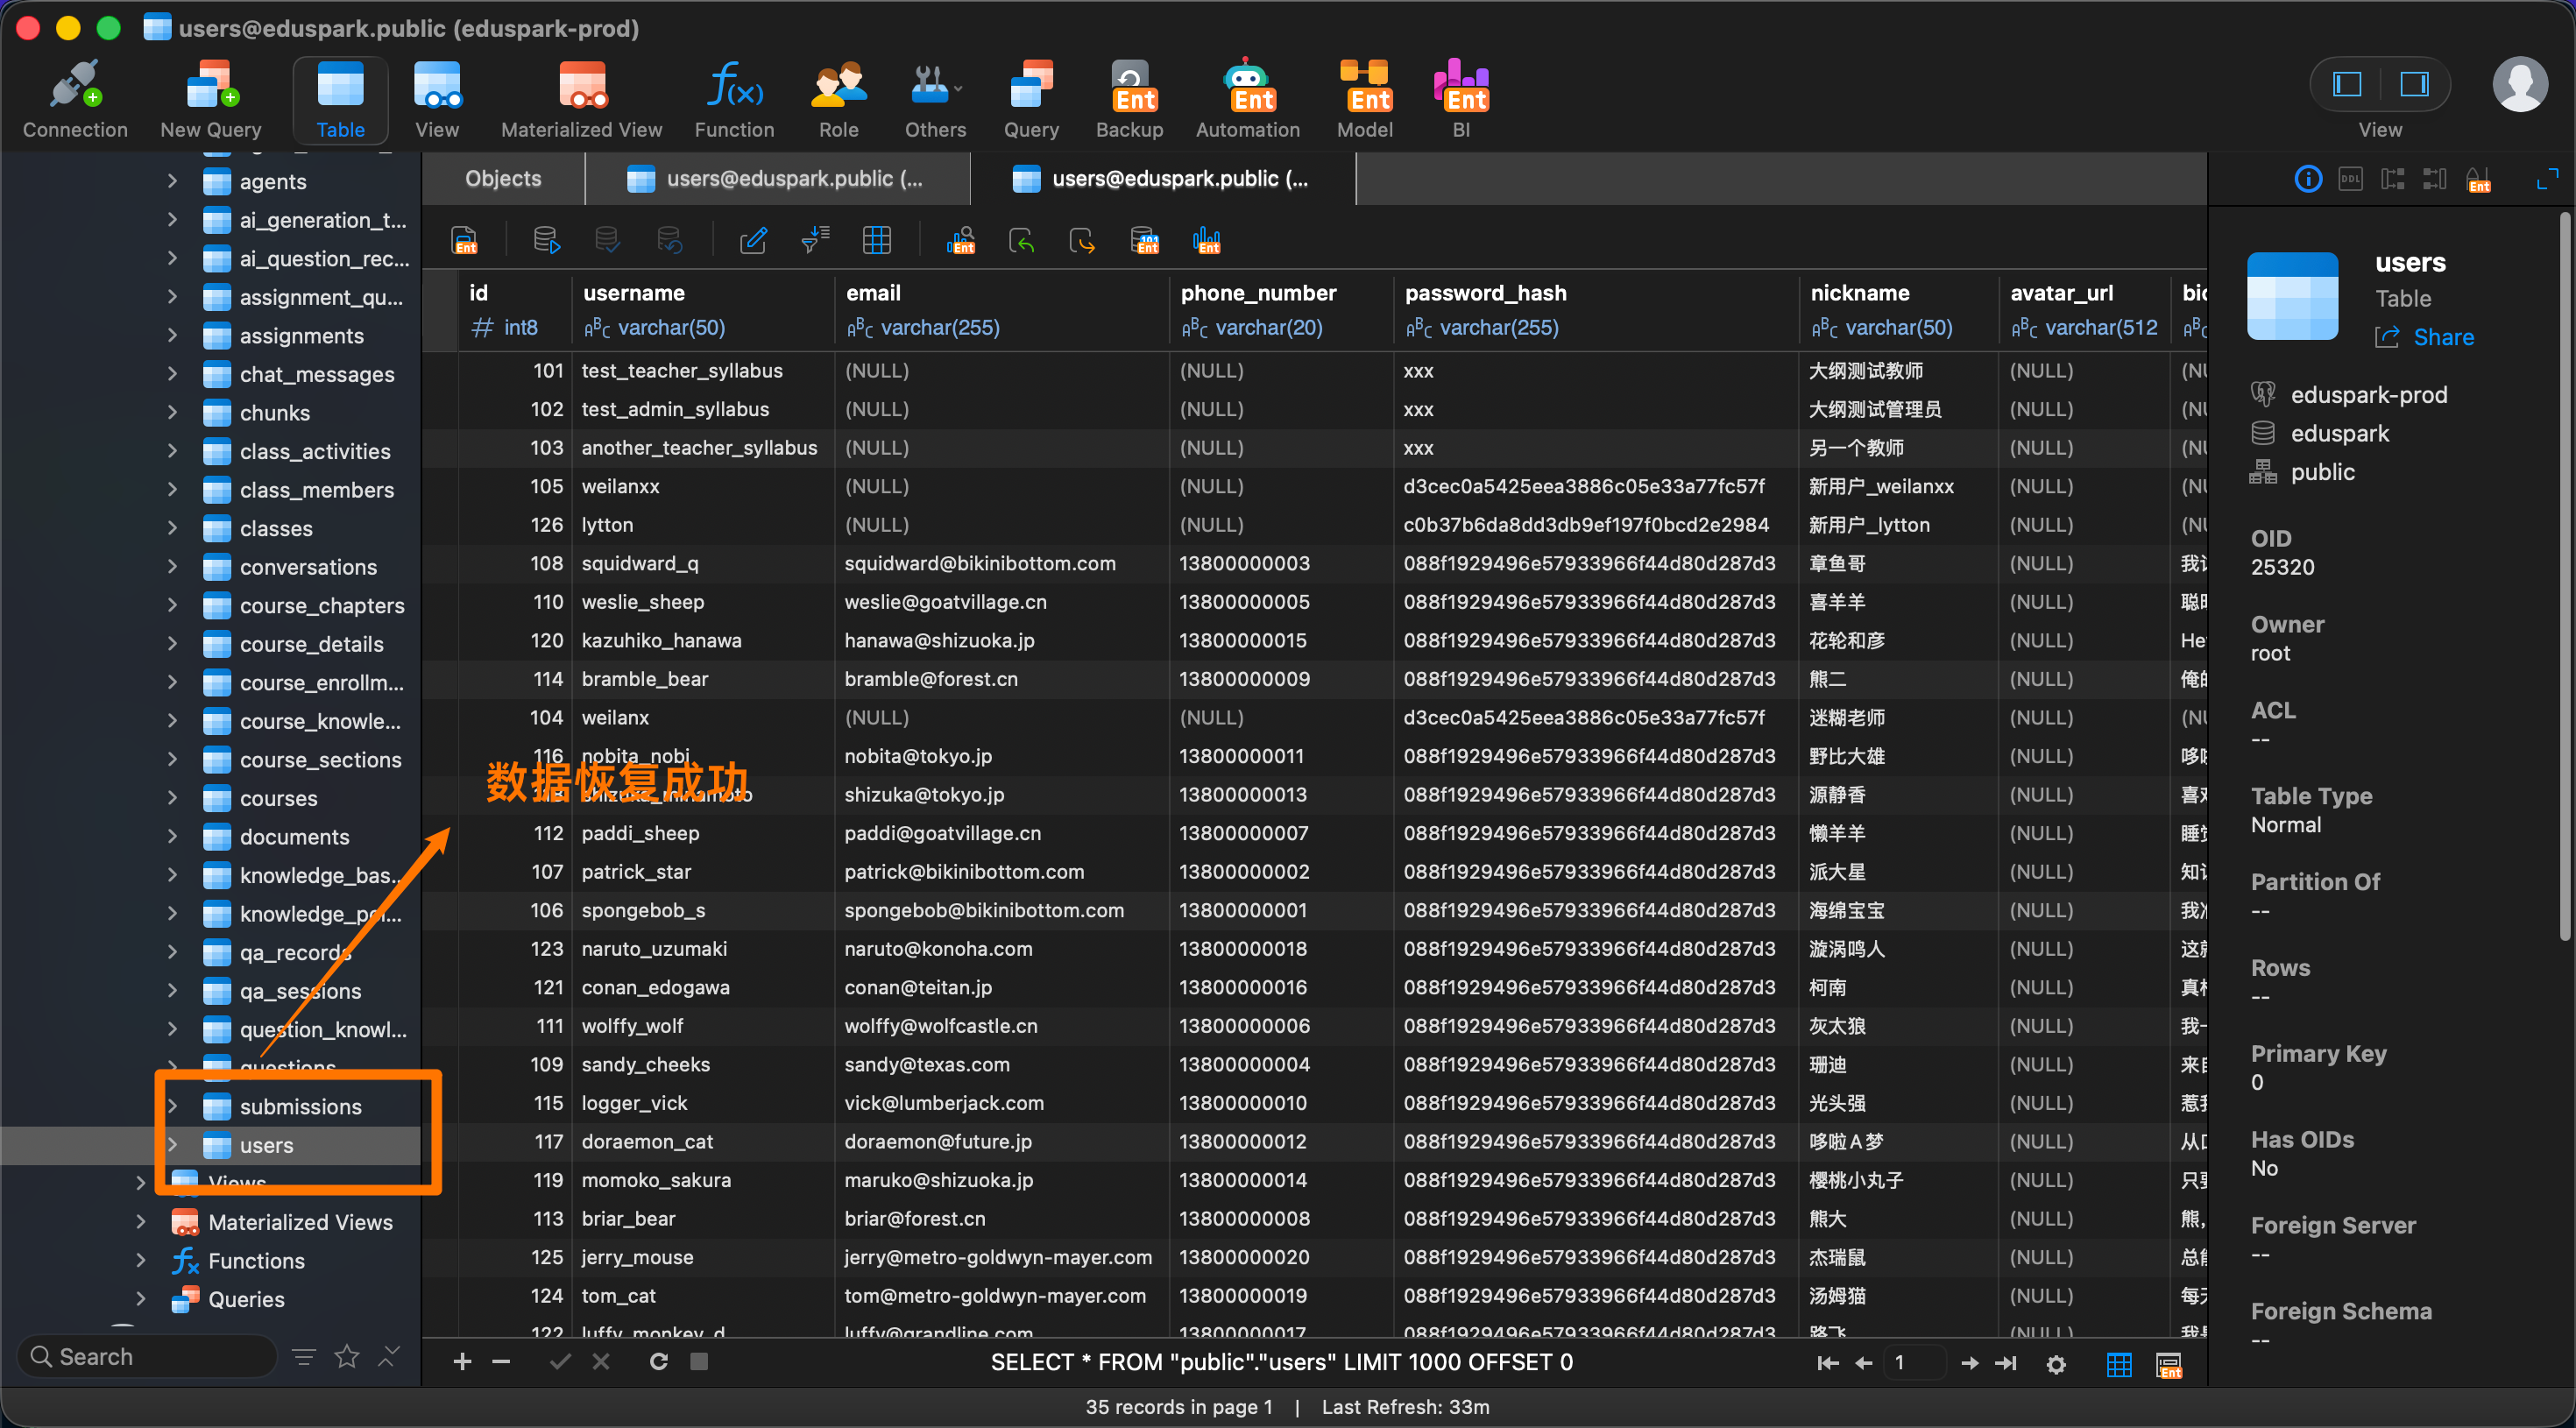
上线复盘,最有价值的不是“修好”,而是“修得可重复”。 现在 EduSpark 的整套流程,从环境预检、镜像回退到数据独立恢复,都写成了脚本里的逻辑。下次再部署,哪怕换个机房,我一根烟的时间就能搞定。
风险清单:
- 使用
latest导致版本漂移(策略:固定版本号) - 镜像代理缺失 Tag(策略:加 Build Fallback)
- 脚本吞掉 Error(策略:
set -e+ON_ERROR_STOP)
有了这一套,以后每一次发布都是体力活,不再是玄学。
记住:做选择的品味和把结果做稳的工程思维,才是 AI 时代搬砖人的核心竞争力。