MySQL 索引:从 B+ 树底层原理到大厂高频考点全解析
MySQL 索引:从 B+ 树底层原理到大厂高频考点全解析
沉默王二@javabetter.cn⚡ 索引核心知识点全景
在深入具体面试题之前,我们先通过以下几个维度梳理 MySQL 索引的全局脉络:
1. 核心架构与原理
- B+ 树结构:MySQL(InnoDB)默认的索引结构。设计核心是「矮胖」,通过多路平衡降低磁盘 IO 次数。
- 叶子节点特性:所有数据存储在叶子节点,且叶子节点通过双向链表连接,天然支持范围扫描和反向遍历。
- 非叶子节点:仅存储索引键值和指针,提高单个页的「分支因子」。
2. 存储模型
- 聚簇索引(Clustered Index):
- 通常是主键。
- 索引即数据:叶子节点直接存放整行记录。
- 唯一性:一张表只能有一个聚簇索引。
- 非聚簇索引(二级索引):
- 叶子节点存储 索引键值 + 主键 ID。
- 查询非索引列时通常需要「回表」。
3. 三大优化机制
- 覆盖索引:查询字段被索引完全覆盖,消除回表过程。
- 最左前缀原则:联合索引的使用准则,匹配必须从最左列开始,不能跳跃。
- 索引下推 (ICP):在存储引擎层提前过滤,大幅减少回表次数。
4. 索引设计禁忌(失效场景)
- 违背最左匹配:跳过排在前面的列。
- 计算/函数/转义:对索引列做运算(如
YEAR()或+1)。 - 模糊通配符开头:
LIKE '%abc'。 - 隐式转换:字符串不加引号导致的类型转换。
📝 索引全量面试题集
以下内容涵盖了文档中关于索引的所有题目、详细解析及对应的大厂面试真题。
35. 🌟 索引为什么能提高 MySQL 查询效率?
索引就像一本书的目录,能让 MySQL 快速定位数据,避免全表扫描。
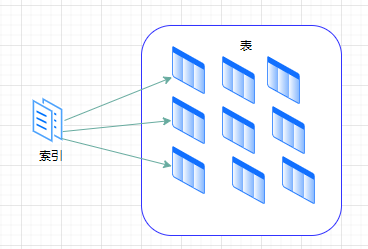
它一般是 B+ 树 结构,查找效率是 $O(\log n)$,比从头到尾扫一遍数据要快得多。
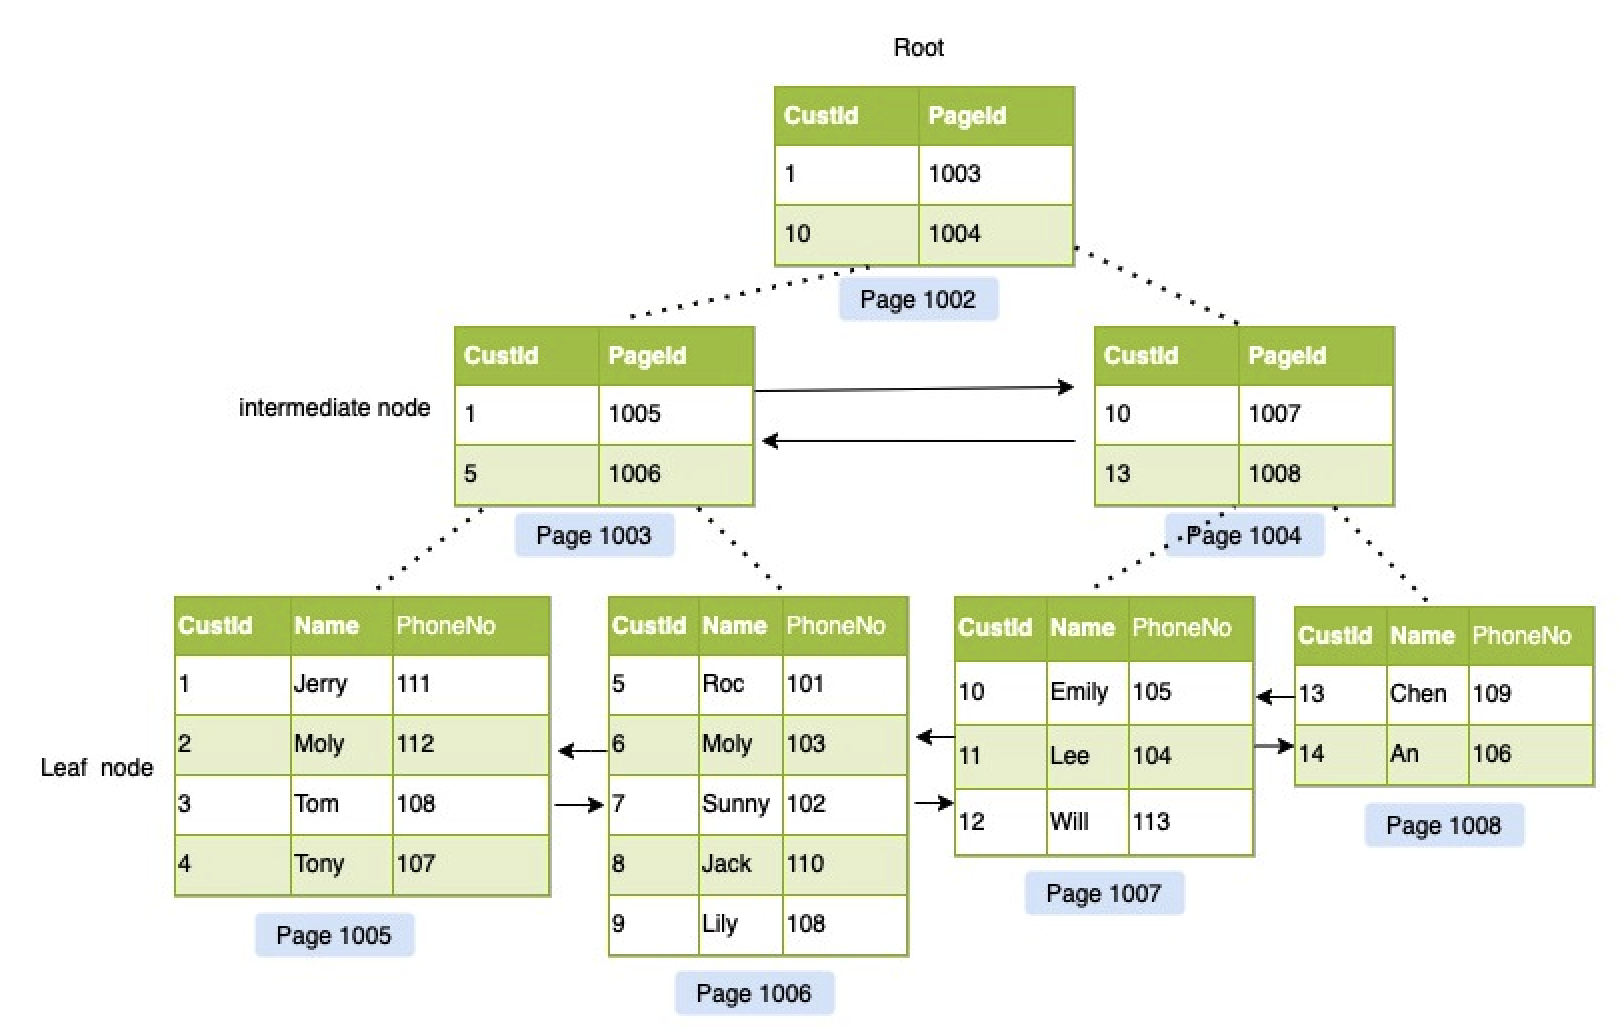
除了查得快,索引还能加速排序、分组、连接等操作。
项目实践:
最常见的做法就是通过 create index 为经常用作查询条件的字段建索引,比如:
1 | create index idx_name on students(name); |
【面试真题库】
- [腾讯] QQ 后台技术一面:MySQL 索引,为什么用 B+ 树
- [小米] Java 后端技术一面:为什么需要索引
- [小公司] Java 后端面试:数据库索引讲一下,然后为什么会加快查询速度
- [去哪儿] 技术二面:MySQL 为什么用索引
- [OPPO] 面试原题:对 MySQL 索引的理解
- [vivo] 技术一面:索引,为什么使用索引更快
- [腾讯] 云后台技术一面:介绍下索引?底层是啥?
36. 🌟 能简单说一下索引的分类吗?
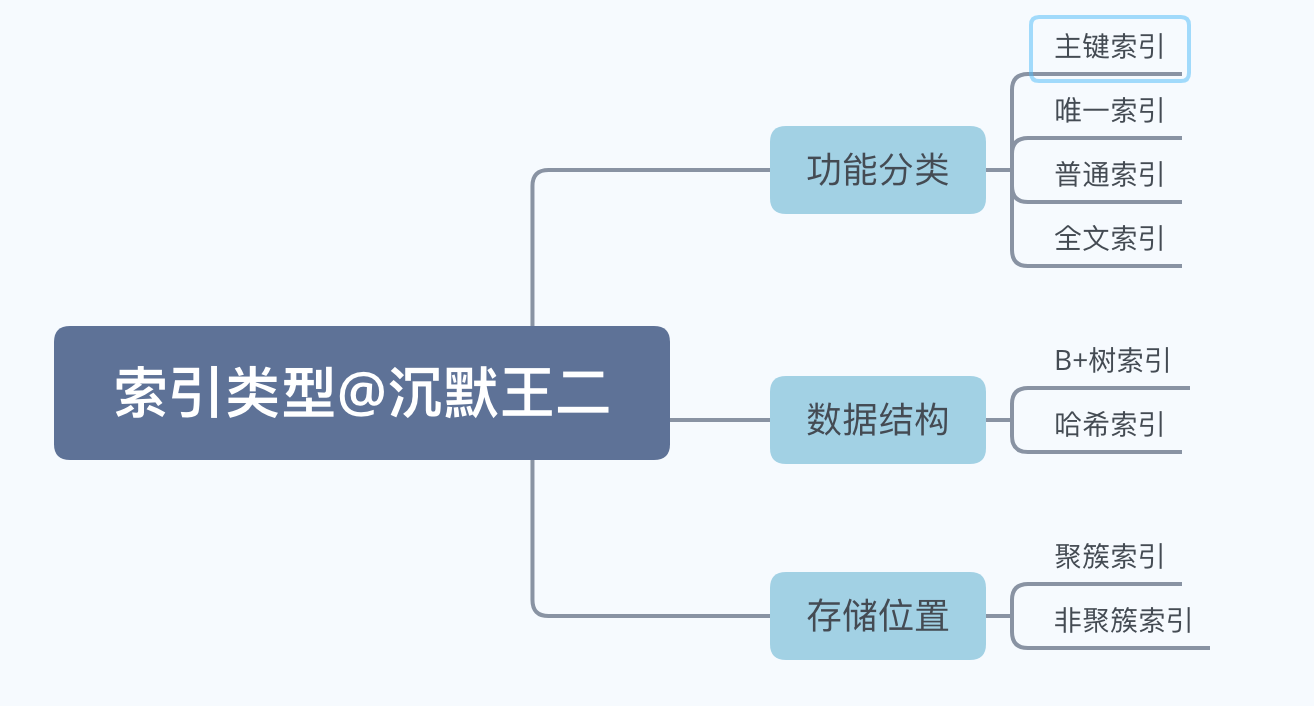
- 按功能分类:主键索引、唯一索引、全文索引。
- 按数据结构分类:B+ 树索引、哈希索引。
- 按存储内容分类:聚簇索引、非聚簇索引。
(1) 主键索引
主键索引用于唯一标识表中的每条记录,其列值必须唯一且非空。
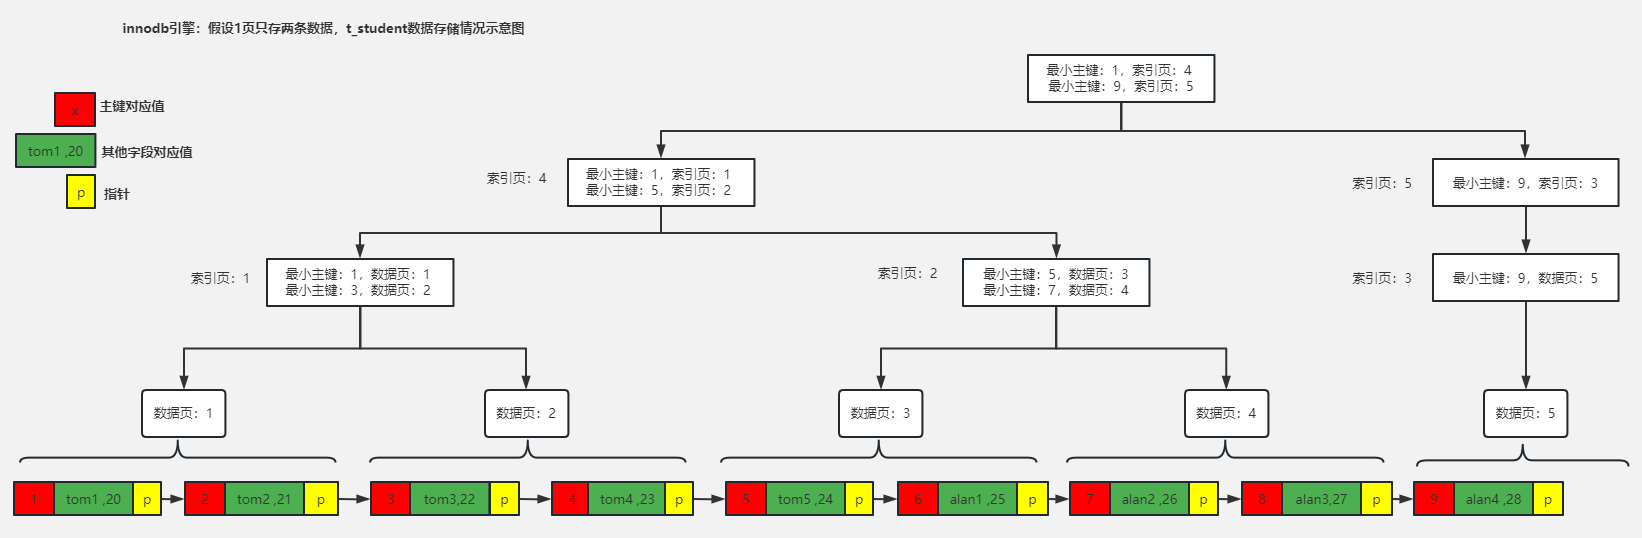
如果在创建表的时候没有指定主键,InnoDB 会优先选择一个非空的唯一索引作为主键;如果没有,则自动生成一个隐藏的 _rowid。
(2) 唯一索引 vs 主键索引
- 主键索引:唯一 + 非空。一个表只能有一个。
- 唯一索引:值必须唯一,但允许插入多个 NULL 值。一个表可以有多个。
(3) 普通索引 vs 唯一索引
- 普通索引:仅用于加速查询,不限制唯一性。
- 唯一索引:强制唯一,插入或更新时会检查约束。
(4) 全文索引
适用于 CHAR、VARCHAR 和 TEXT 字段,优化长文本检索。
- MySQL 5.7+ 内置 ngram 解析器处理中、日、韩分词。
- 使用
MATCH...AGAINST进行检索,性能远高于LIKE '%keyword%'。
【面试真题库】
- [科大讯飞] 非凡计划:聊聊 MySQL 的索引
- [腾讯] QQ 后台:MySQL 索引,为什么用 B+ 树
- [携程] 暑期实习一面:讲一讲 MySQL 的索引
- [阿里妈妈] 技术一面:索引的分类,创建索引的最佳实践
- [360] 技术一面:MySQL 的索引用过哪些
- [用友] 面试原题:索引是什么?有哪些索引
- [作业帮] Java 后端一面:普通索引的叶子节点存储的是什么
- [作业帮] Java 后端一面:InnoDB 底层有哪些数据结构
- [比亚迪] 技术面试:索引有哪些,区别是什么
37. 🌟 创建索引有哪些注意点?
- 选择合适的字段:
- 频繁出现在
WHERE、JOIN、ORDER BY里的字段。 - 区分度要高(如用户 ID、手机号),避免性别等低区分度字段。
- 频繁出现在
- 控制数量:避免过度索引。单表建议不超过 5 个,过多的索引会显著降低写操作性能。
- 遵循最左前缀:联合索引设计时,区分度最高的放在最左侧。
- 等值优先:等值查询在范围查询之前。
【面试真题库】
- [用友金融] 一面:索引的作用,加索引需要注意什么
- [京东] 后端实习:查询和更新都频繁的字段是否适合创建索引
- [小米] 春招一面:索引怎么设计才是最好的
- [京东] 技术一面:MySQL 索引结构,建立索引的策略
- [阿里妈妈] 技术一面:创建索引的最佳实践
- [OPPO] 秋招一面:建索引的时候应该注意什么
- [京东] 技术一面:建立索引考虑哪些问题
38. 🌟 索引哪些情况下会失效呢?
- 左模糊查询:
LIKE '%xxx'会失效。 - 列参与运算/函数:
WHERE YEAR(date) = 2023失效;WHERE id + 1 = 10失效。 - 违背最左前缀原则:跳过联合索引的第一列。
- OR 连接非索引列:
WHERE id = 1 OR age = 20(age 无索引) 会导致 id 索引也失效。 - 不等于查询:
!=或<>有时会导致全表扫描。
【面试真题库】
- [字节跳动] 技术一面:where b=5 是否一定会命中索引?(失效场景)
- [京东] 技术一面:索引失效的情况
- [比亚迪] 技术面试:索引失效场景
- [OPPO] 面试原题:什么情况下索引失效?
- [理想汽车] 一面:什么操作会导致索引失效?
39. 索引不适合哪些场景呢?
- 数据量太小:数据量小于 1000 行,全表扫描可能比索引查完再回表更快。
- 区分度极低的列:如「性别」字段。
- 频繁更新的列:每次更新都要维护 B+ 树。
- 由于 TEXT/BLOB 等大字段。
什么是区分度?
公式:COUNT(DISTINCT column) / COUNT(*)。越接近 1 越适合索引。
【面试真题库】
- [字节跳动] 二面:性别字段要建立索引吗?什么是区分度?
- [快手] 一面:什么样的字段适合加索引?什么不适合?
40. 索引优化的思路?
- 慢日志:定位 SQL 瓶颈。
- EXPLAIN 分析:查看执行计划,重点看
type、key和Extra。 - 精简索引:合并冗余索引,利用联合索引代替多个单列索引。
- 利用覆盖索引:让索引包含所有返回字段。
【面试真题库】
- [比亚迪] 技术面试:索引优化的思路
41. 🌟 为什么 InnoDB 要使用 B+ 树作为索引?
核心三点:
- 更矮胖:相比二叉树,B+ 树分支因子极大(16KB/页),3 层就能存 2000 万数据。IO 次数少。
- 范围查询:叶子节点通过双向链表相连,极其适合
BETWEEN、ORDER BY操作。B 树不支持如此高效的范围扫描。 - 稳定性:所有查询必须到叶子节点,查询耗时稳定。
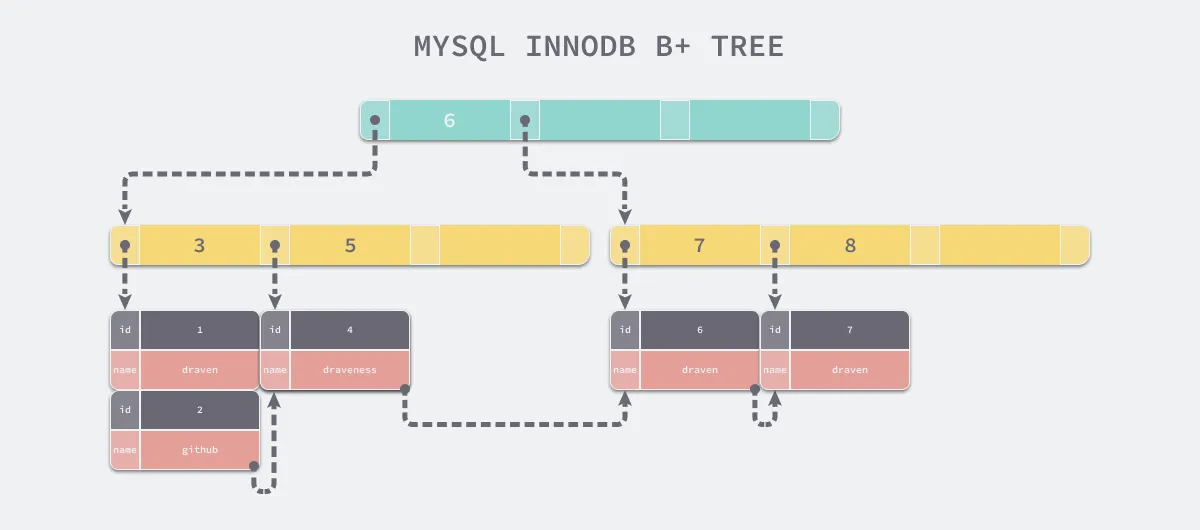
B+ 树 vs B 树、Hash、红黑树
- vs Hash:Hash 不支持范围查询和排序。
- vs B 树:B 树非叶子节点也存数据,导致层数变高,且不支持链表顺序扫。
- vs 二叉树:层级太深,IO 寻址次数过多。
【面试真题库】
- [字节跳动] 说说 B+ 树,为什么 3 层能存 2000 万?
- [腾讯] 为什么选用 B+ 树?
- [小米] 说一说 MySQL 索引的底层机制
- [得物] MongoDB 为什么用 B 树,MySQL 为何用 B+ 树?
- [百度] B+ 树叶子是单向还是双向链表?大值向小值检索怎么做?
42. 🌟 一棵 B+ 树能存储多少条数据呢?
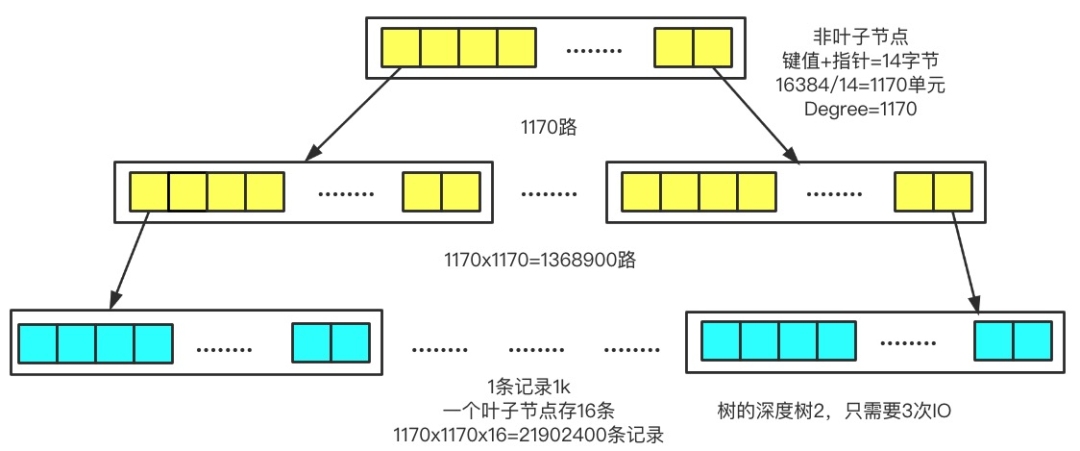
答案:约 2000 万条。
计算推导:
- InnoDB 页默认 16KB。
- 非叶子节点:存
(主键 ID + 指针)。主键 8B + 指针 6B = 14B。一个页能存 $16384 / 14 \approx 1170$ 个指针。 - 叶子节点:存行数据。假设一行 1KB,一个页存 16 条。
- 三层容量:$1170 \times 1170 \times 16 \approx 21,902,400$。
【面试真题库】
- [奇安信] 2KW 数据,B+ 树高度几层?(3层)
- [美团] 一张表最多存多少数据?(常答 2KW,基于 3 层树计算)
- [腾讯] 叶子节点能存多少条数据?(取决于行大小,一般 1KB 存 16 条)
43-44. B+ 树 vs B 树 vs 跳表
(1) B+ 树 vs B 树(图书馆类比)
- B 树:像普通图书馆,每一层书架都有书。层级深(树高),找书要爬上爬下。
- B+ 树:索引层只有目录(矮胖),书全在底层逻辑连接。
(2) B+ 树 vs 跳表(登山缆车类比)
- 跳表:像缆车,每层都是指针。存 2000 万数据要 20 层,导致 20 次随机磁盘 IO。
- B+ 树:只要 3 次 IO。跳表适合内存(如 Redis),B+ 树才是磁盘王者。
【面试真题库】
- [贝壳找房] 为什么用 B+ 树不用 B 树?
- [饿了么] 索引为什么用 B+ 树不用跳表?时间复杂度对比?
45. B+ 树索引和 Hash 索引的区别?
- Hash 索引:等值查找 $O(1)$。但不支持范围、排序、模糊匹配、最左匹配。
- B+ 树索引:支持 $O(\log N)$ 查找及所有高级用法。
46. 🌟 聚簇索引和非聚簇索引的区别?
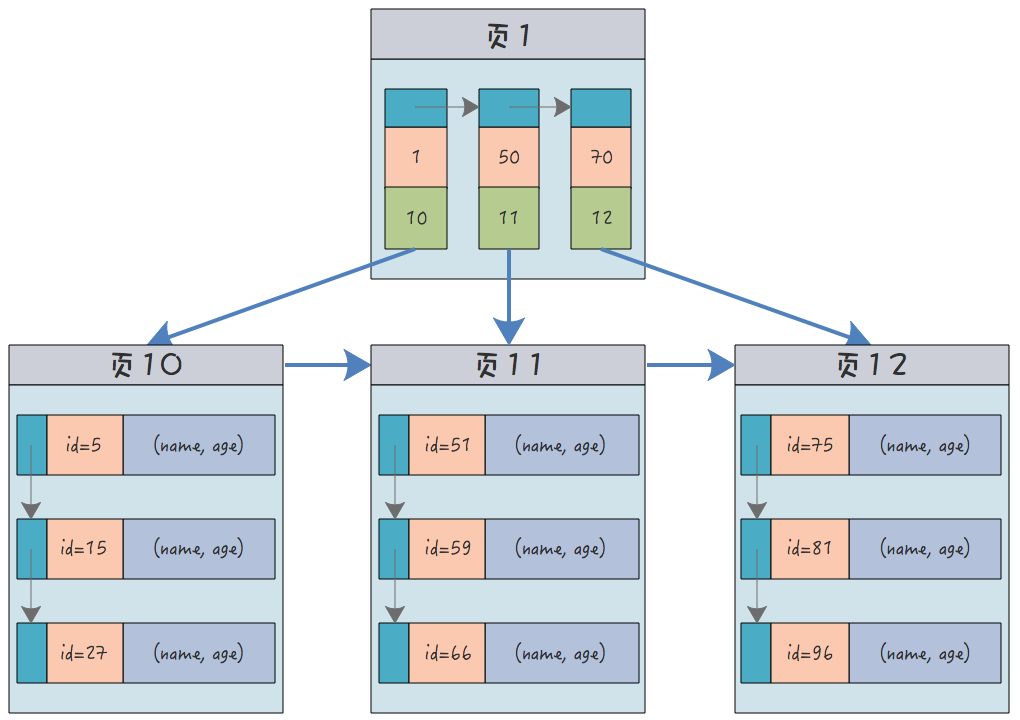
- 聚簇索引:叶子节点存 完整数据行。一张表只有一个。
- 非聚簇索引:叶子节点存 主键 ID。查询时常涉及「回表」。
【面试真题库】
- [支付宝] 聚簇索引和非聚簇索引的区别?
- [快手] 区别是什么?
- [腾讯] 索引怎么存的?每个索引一个 B+ 树吗?
47. 🌟 回表了解吗?
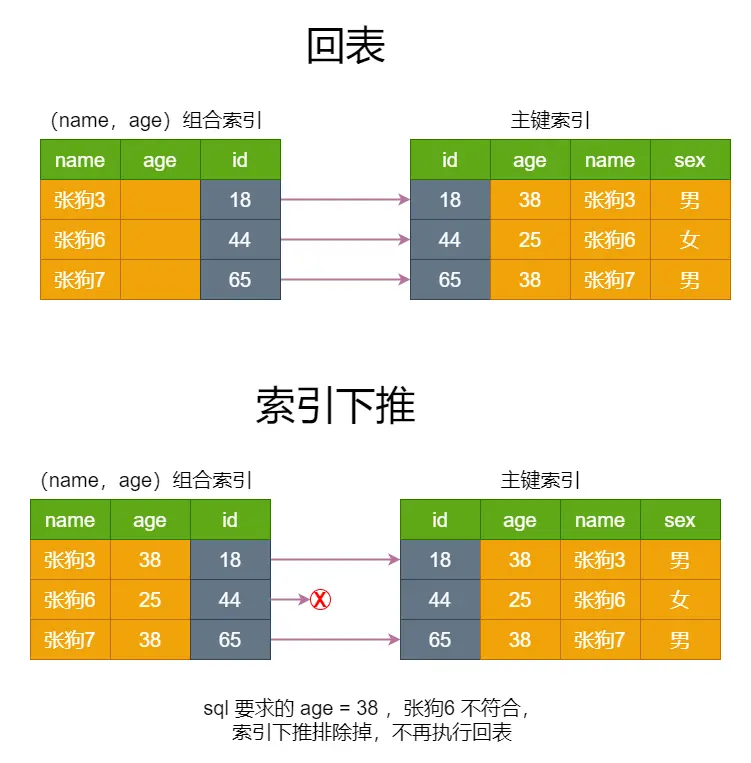
定义:通过二级索引查到主键,再通过主键查聚簇索引获取全行数据的过程。
了解 MRR 吗? MRR (Multi-Range Read) 会将主键列表排序后再按序回表,将 随机 IO 转为顺序 IO。
48-50. 联合索引与最左前缀原则
(1) 联合索引结构
联合索引 (A, B, C) 在 B+ 树中按字段顺序排列。
(2) 最左前缀原则
必须从最左列开始。如 (A, B, C):
WHERE A=1 AND B=2:匹配。WHERE B=2:失效。WHERE A=1 AND C=3:A 匹配,C 丢弃(无法定位)。
【面试真题库】
- [百度] 联合索引底层存储结构?
- [美团] 覆盖索引,回表过程?
- [字节跳动]
(a,b,c)联合索引,select * where a=1 and b in (1,2) and c>3走索引吗?(走)
51. 🌟 什么是索引下推 (ICP)?
定义:在索引扫描过程中,服务器将部分 WHERE 条件过滤操作推送到存储引擎。
- 效果:减少回表次数。原本需要回表判断的条件,在索引层直接踢掉。
52. 如何查看是否用到了索引?
使用 EXPLAIN。
key列显示实际用的索引。Extra显示Using index condition说明命中索引下推。
场景实操:联合索引 abc
a=1, c=1:命中 a 索引(ICP 过滤 c)。b=1, c=1:全表扫描。a=1, c=1, b=1:命中全索引(优化器重排)。
💡 总结建议: 大厂面试官最爱问 “为什么”。不要只背结论,要推导过程:
- B+ 树更矮胖 $\rightarrow$ 减少随机磁盘 IO。
- 指针 + 键值 $\rightarrow$ 提高页的存储效率 $\rightarrow$ 增加分支因子。
- 最左匹配 $\rightarrow$ 因为 B+ 树在构建索引键时是按字段顺序全局排序的。