从零构建20万节点林业知识图谱:一次被面试官问怕了的技术探险
从零构建20万节点林业知识图谱:一次被面试官问怕了的技术探险
蔚蓝WEILANX哈喽,大家好呀,我是蔚蓝,今天我们来聊聊知识图谱——一个在 AI 时代被反复提及,但真正落地时让人抓耳挠腮的技术。
这事儿得从我做 DeepForest 林业智能问答系统说起。项目做完后去面试,面试官盯着简历上的「知识图谱」四个字,问题一个接一个:Schema 怎么设计的?实体怎么抽取的?为什么用 Neo4j 不用 MySQL?图谱怎么和 RAG 结合?幻觉率降低了多少?
当时有点慌。但正因为被问怕了,今天这篇文章才有了实战的温度。
你的脑子不是 Excel,是网络
先说个事儿。
你记知识的方式,更像 Excel 表格还是更像个网络?
大多数人会说网络。因为知识点之间有联系——松材线虫寄生在松树上,松树分布在华东地区,华东地区又有其他病虫害…
这就像你去一个陌生城市找路。Excel 是那种把所有街道名写在一张表里的方式,你想从 A 到 B,得自己在表里一行行找、一条条拼。知识图谱不一样,它直接给你一张地图,A 到 B 之间的路一目了然,沿着走就行。
数据量小的时候,Excel 式的表格查询还行。一旦到了几十万条,四表联查能把数据库拖死。图谱呢?沿着 HOSTS_ON 和 DISTRIBUTED_IN 两条边遍过去,毫秒级返回。
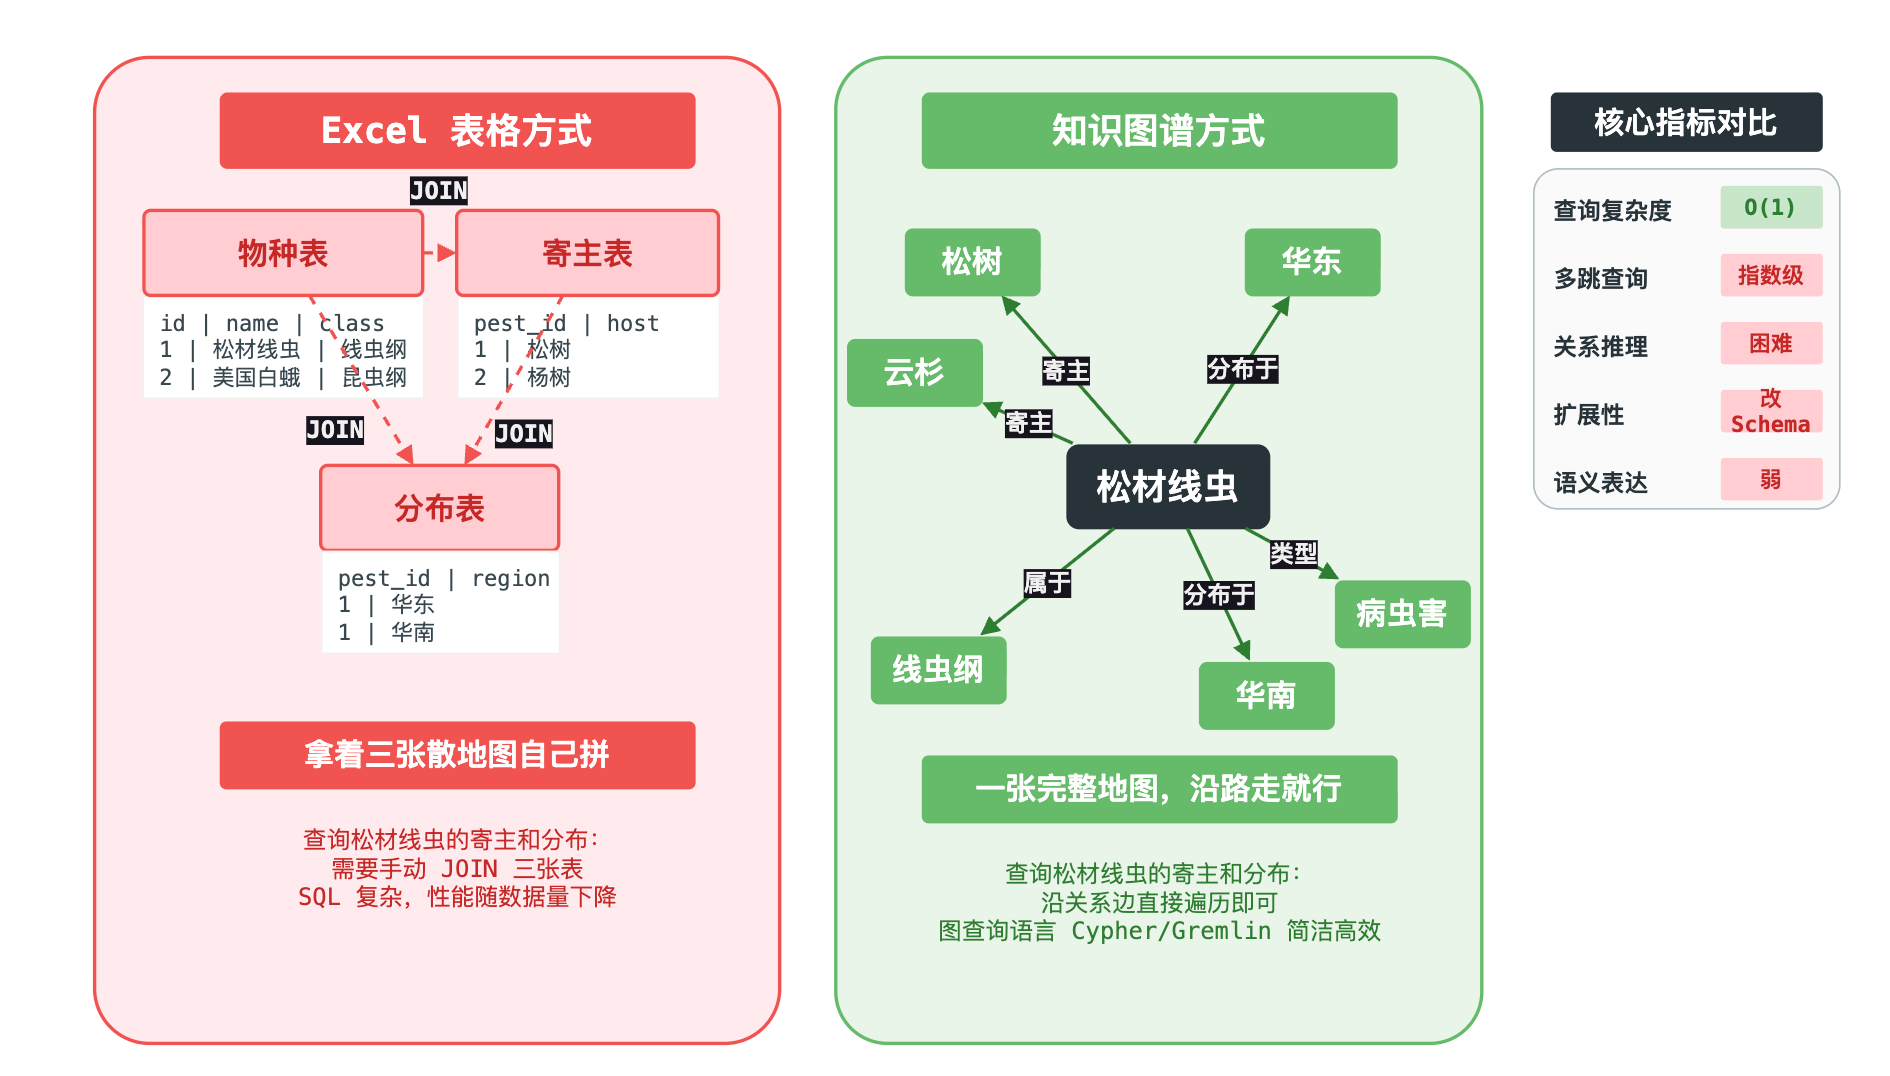
表格存记录,图谱存关系。 这就是核心区别。
Schema 设计:先想清楚你要存什么
动手之前,先想清楚你要解决什么问题。
DeepForest 的核心场景是林业病虫害问答。用户会问:「松材线虫病怎么防治?」「华东地区松树上有哪些病虫害?」「这个虫害的寄主植物有哪些?」
这些问题背后,隐藏着几类实体和它们之间的关系。
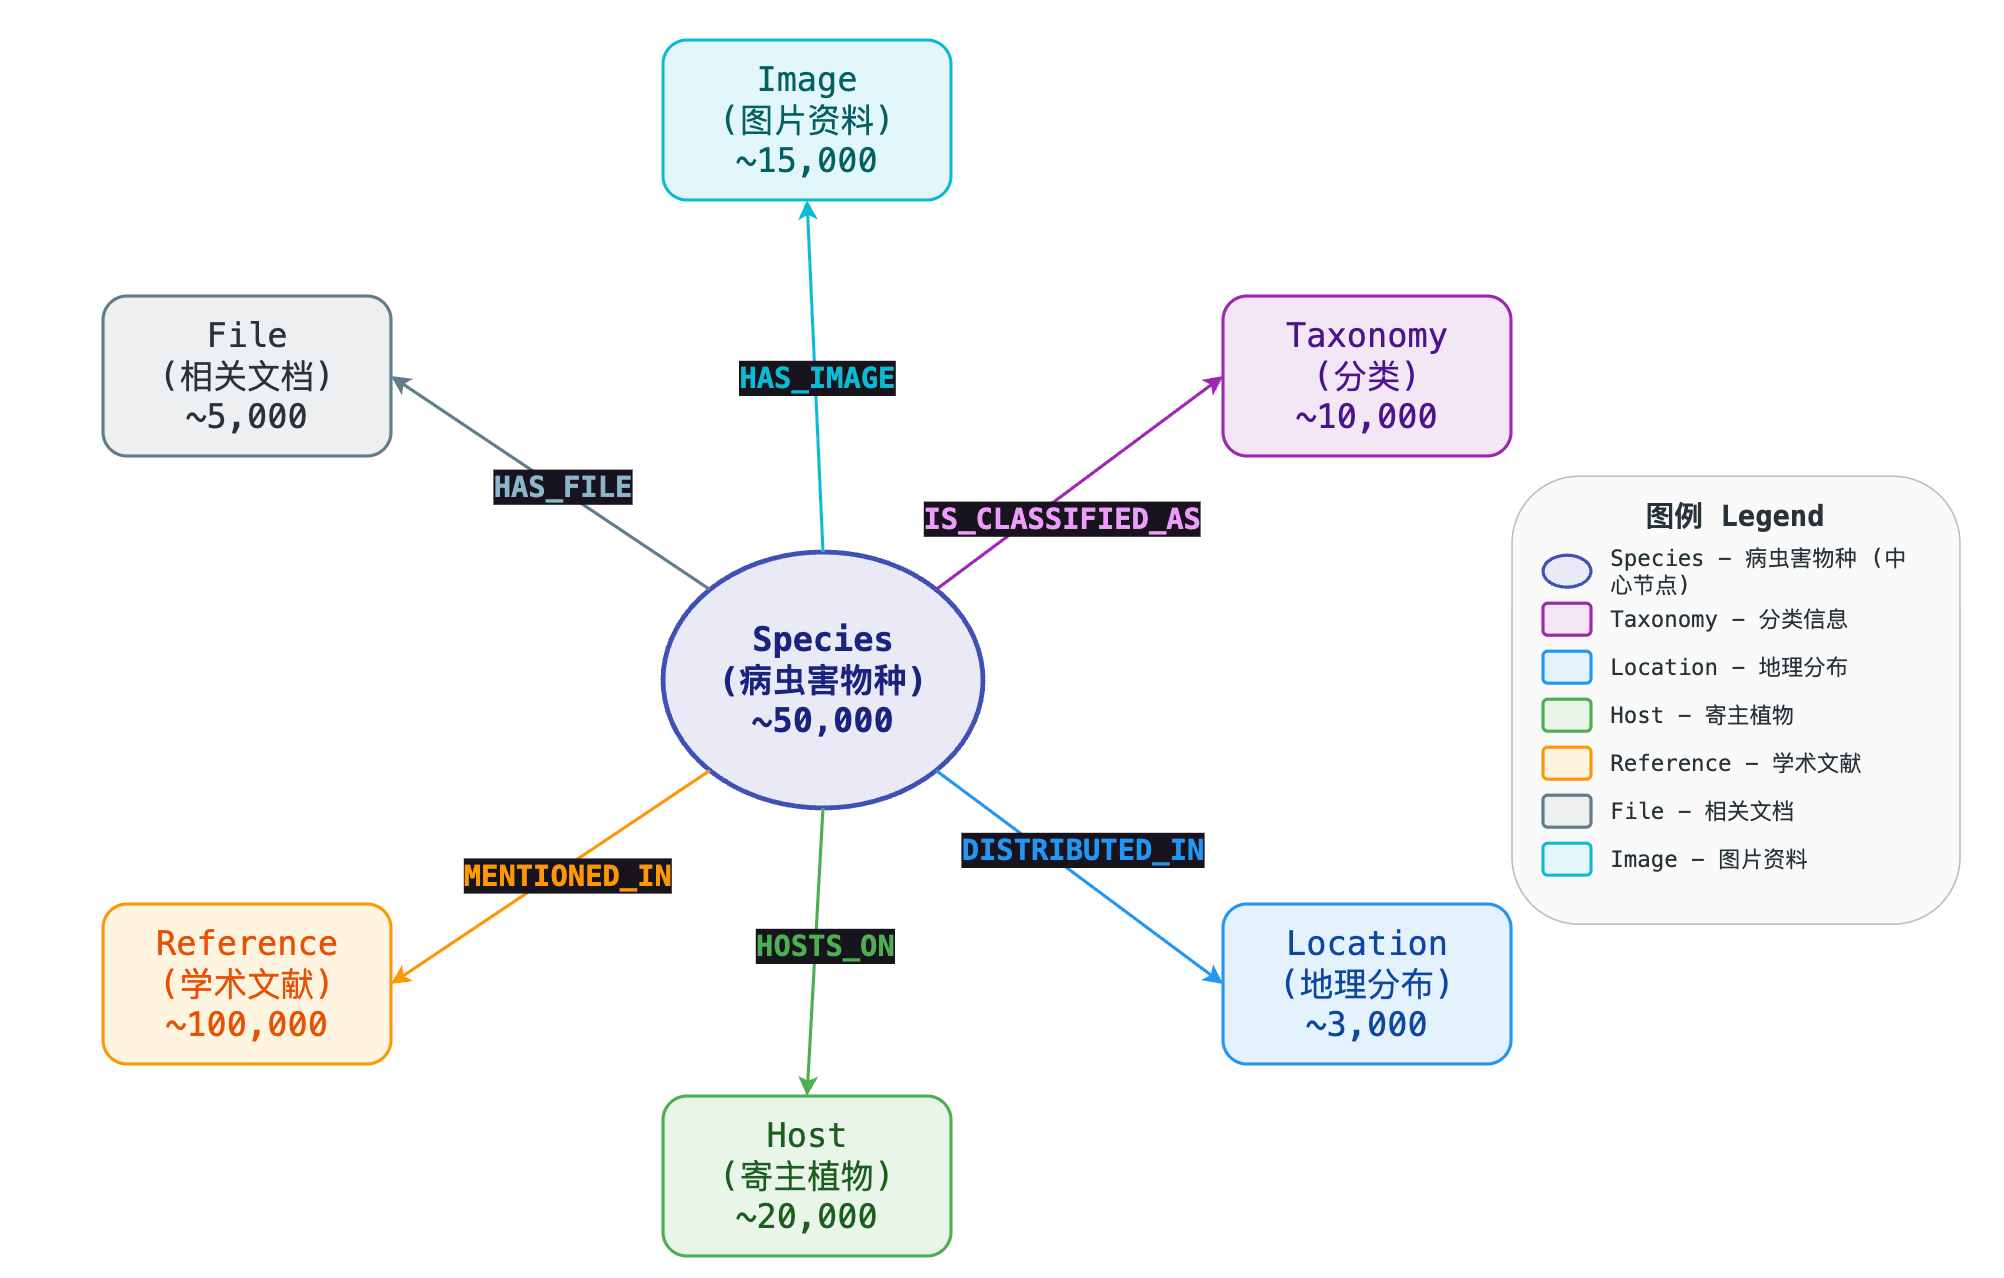
实体设计(7 类节点)
| 节点类型 | 含义 | 数量级 |
|---|---|---|
| Species | 病虫害物种 | ~50,000 |
| Taxonomy | 分类(门纲目科属种) | ~10,000 |
| Location | 地理分布 | ~3,000 |
| Host | 寄主植物 | ~20,000 |
| Reference | 学术文献 | ~100,000 |
| File | 相关文档 | ~5,000 |
| Image | 图片资料 | ~15,000 |
关系设计(6 种边)
| 关系类型 | 含义 |
|---|---|
| IS_CLASSIFIED_AS | 物种的分类层级 |
| DISTRIBUTED_IN | 物种的地理分布 |
| HOSTS_ON | 病虫害寄生在哪些植物上 |
| MENTIONED_IN | 物种被哪些文献记载 |
| HAS_FILE | 关联的文档资料 |
| HAS_IMAGE | 关联的图片资料 |
一眼识别:好的 Schema 设计,应该能直接映射到用户的提问方式。用户问「A 的 B 有哪些 C」,你的图谱就应该有 A→B→C 的路径。
数据从哪来?爬虫 + 清洗 + 抽取
Schema 设计好了,数据呢?
这部分就像装修房子。设计图画得再漂亮,最后还是得一砖一瓦地砌。数据采集就是搬砖,数据清洗就是刮腻子,实体抽取就是精装修。每一步都是脏活累活,但跳过任何一步,房子都住不了。
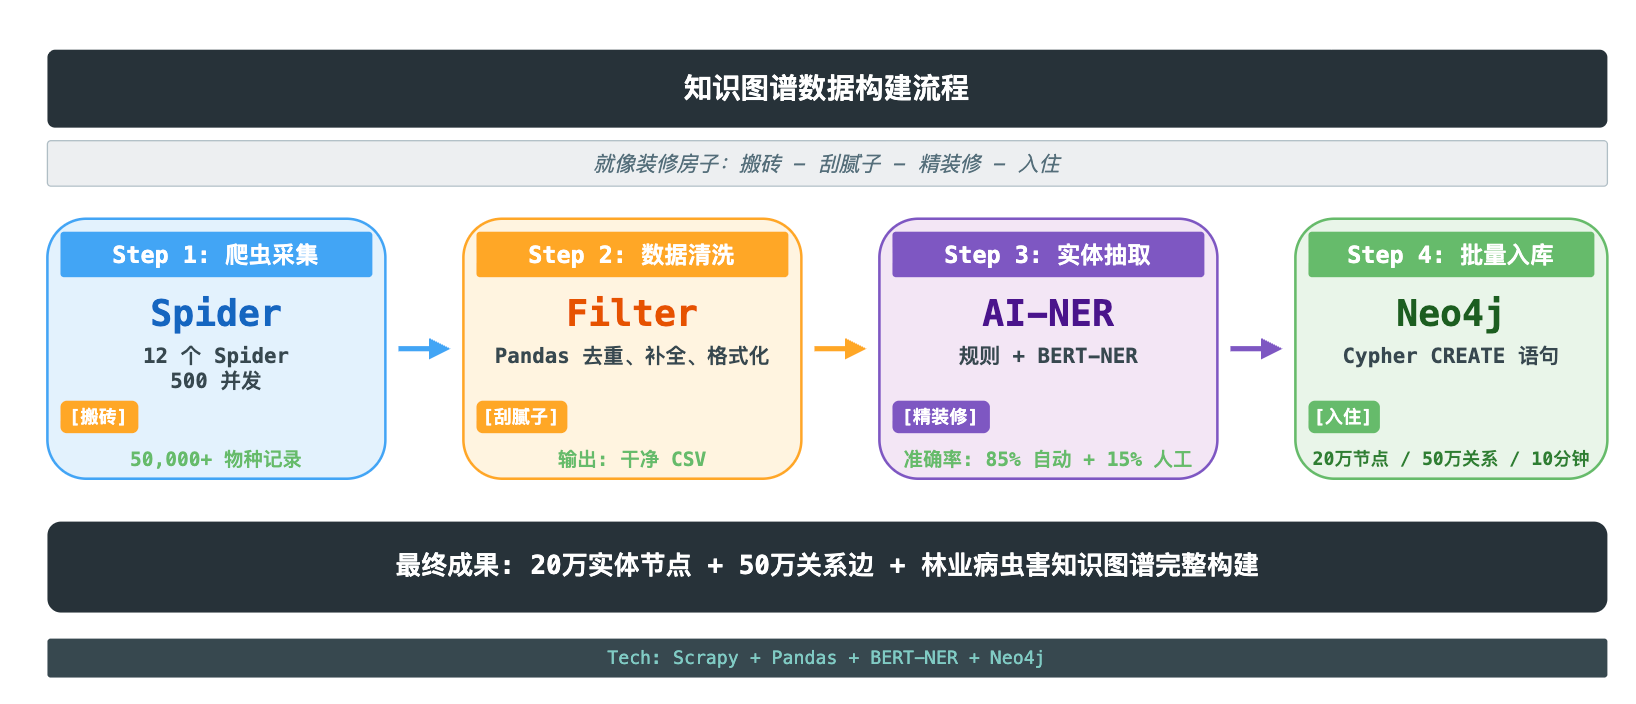
第一步:爬虫采集
Scrapy 分布式爬虫,12 个 Spider,覆盖病虫害百科、学术论文、地理分布等多源数据。500 并发,累计采集 50,000+ 物种记录。
反爬策略:User-Agent 轮换 + 请求频率随机化 + 代理 IP 池。这事儿不展开说,懂的都懂。
第二步:数据清洗
爬下来的 JSON 是脏的。重复数据、缺失字段、格式不统一…Pandas 一顿操作,输出干净的 CSV。
第三步:实体关系抽取
这是最耗时的部分。
规则抽取:正则匹配。比如「寄主:松树、杉树」这种固定格式,写个正则就能抽。
NLP 抽取:非结构化文本,用实体识别模型。我们用的是基于 BERT 的中文 NER 模型,识别物种名、地名、植物名。
避坑指南:别指望 100% 准确。我们做到了 85% 左右,剩下 15% 人工校验。自动化虽好,但该人肉的时候别省。
第四步:批量入库
Neo4j 的批量导入用 CREATE 语句。20 万节点、50 万关系,大概 10 分钟入库完毕。
1 | // 批量创建节点 |
为什么用 Neo4j 不用 MySQL?
面试必问题。
还是用找路的比喻。MySQL 处理多跳查询,就像你拿着三张不同的地图,要自己把它们拼在一起才能找到路。Neo4j 呢,一张完整的地图,手指沿着路划过去就到了。
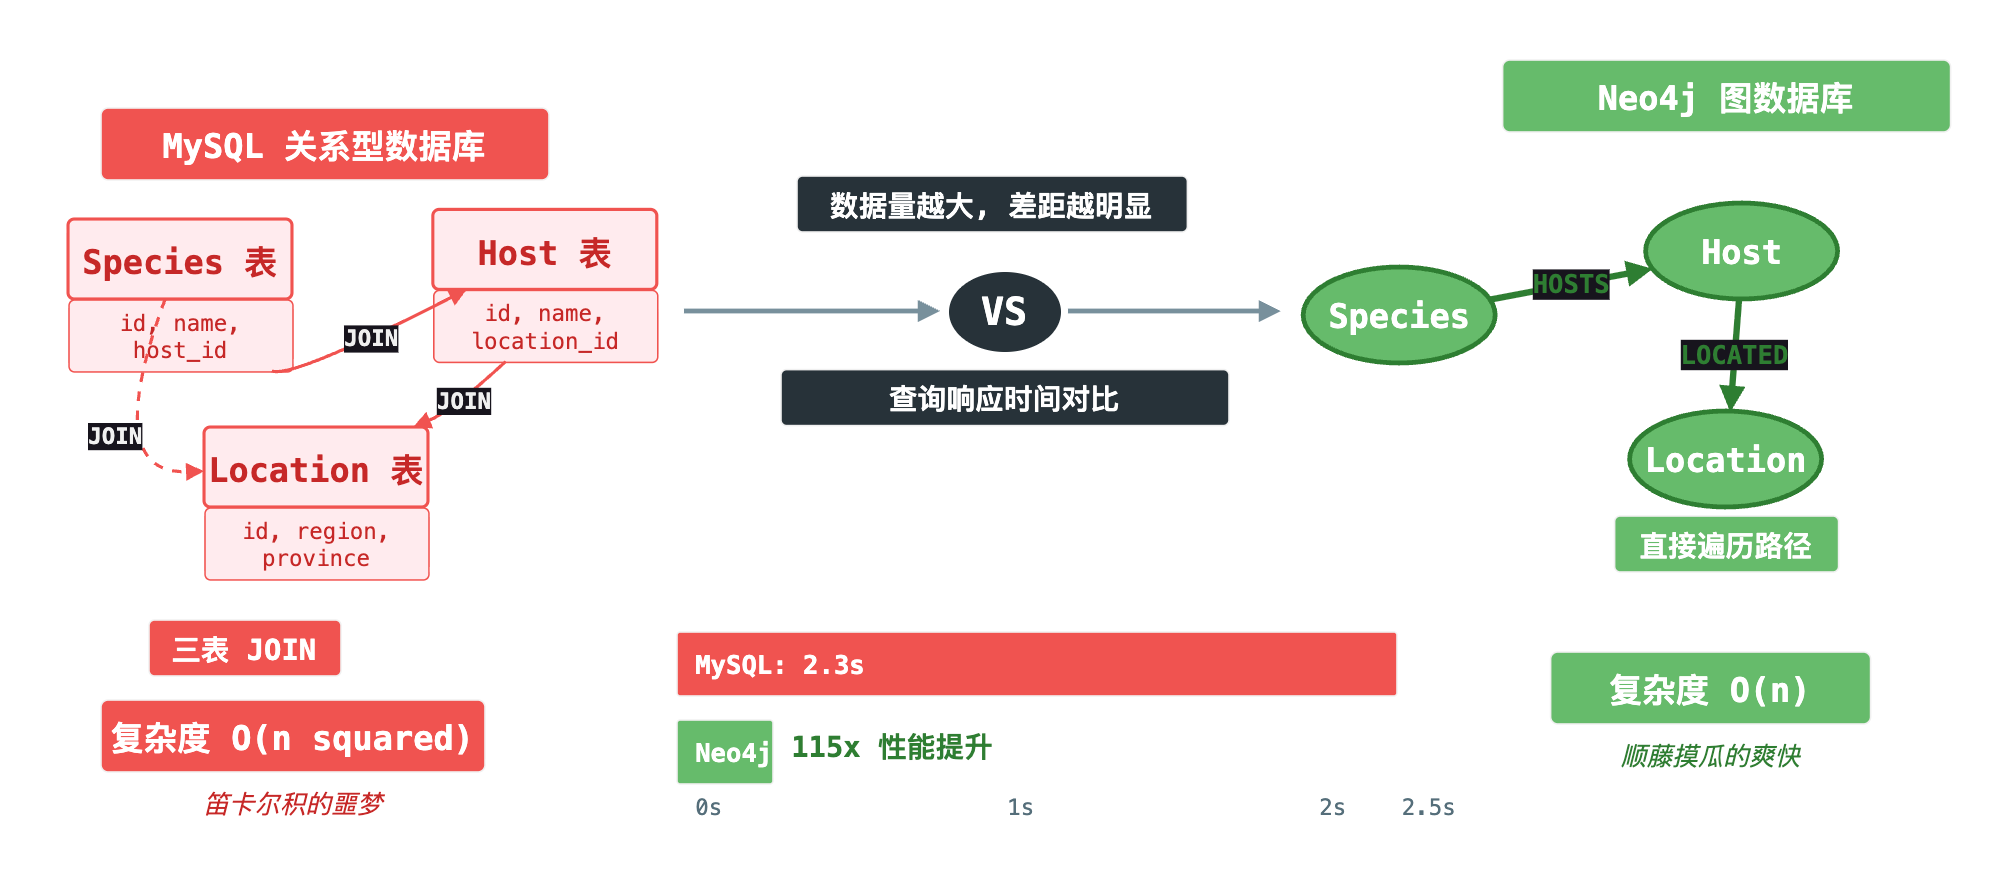
病虫害领域有大量多跳查询。比如「该虫害的寄主植物分布在哪些地区」,路径是:物种 → 寄主 → 分布区域。MySQL 需要三表 JOIN,复杂度 O(n²)。Neo4j 是图遍历,复杂度 O(n)。数据量越大,差距越明显。
JOIN 是笛卡尔积的噩梦,图遍历是顺藤摸瓜的爽快。
知识图谱 + RAG:这才是杀手锏
单独用知识图谱?不够。单独用向量检索?也不够。
为什么?
向量检索擅长语义相似。「怎么治松材线虫」能召回「松材线虫防治方法」相关的文档。但它不擅长精确匹配。专有名词「松材线虫」可能被召回成「松树病虫害」,漏了关键实体。
图谱查询是精确的。MATCH (s:Species {name: '松材线虫'})-[:HOSTS_ON]->(h:Host) 返回的一定是松材线虫的寄主植物,不会召回无关实体。
一个模糊但广,一个精确但窄。两者结合才是正解。
三路召回 + RRF 融合
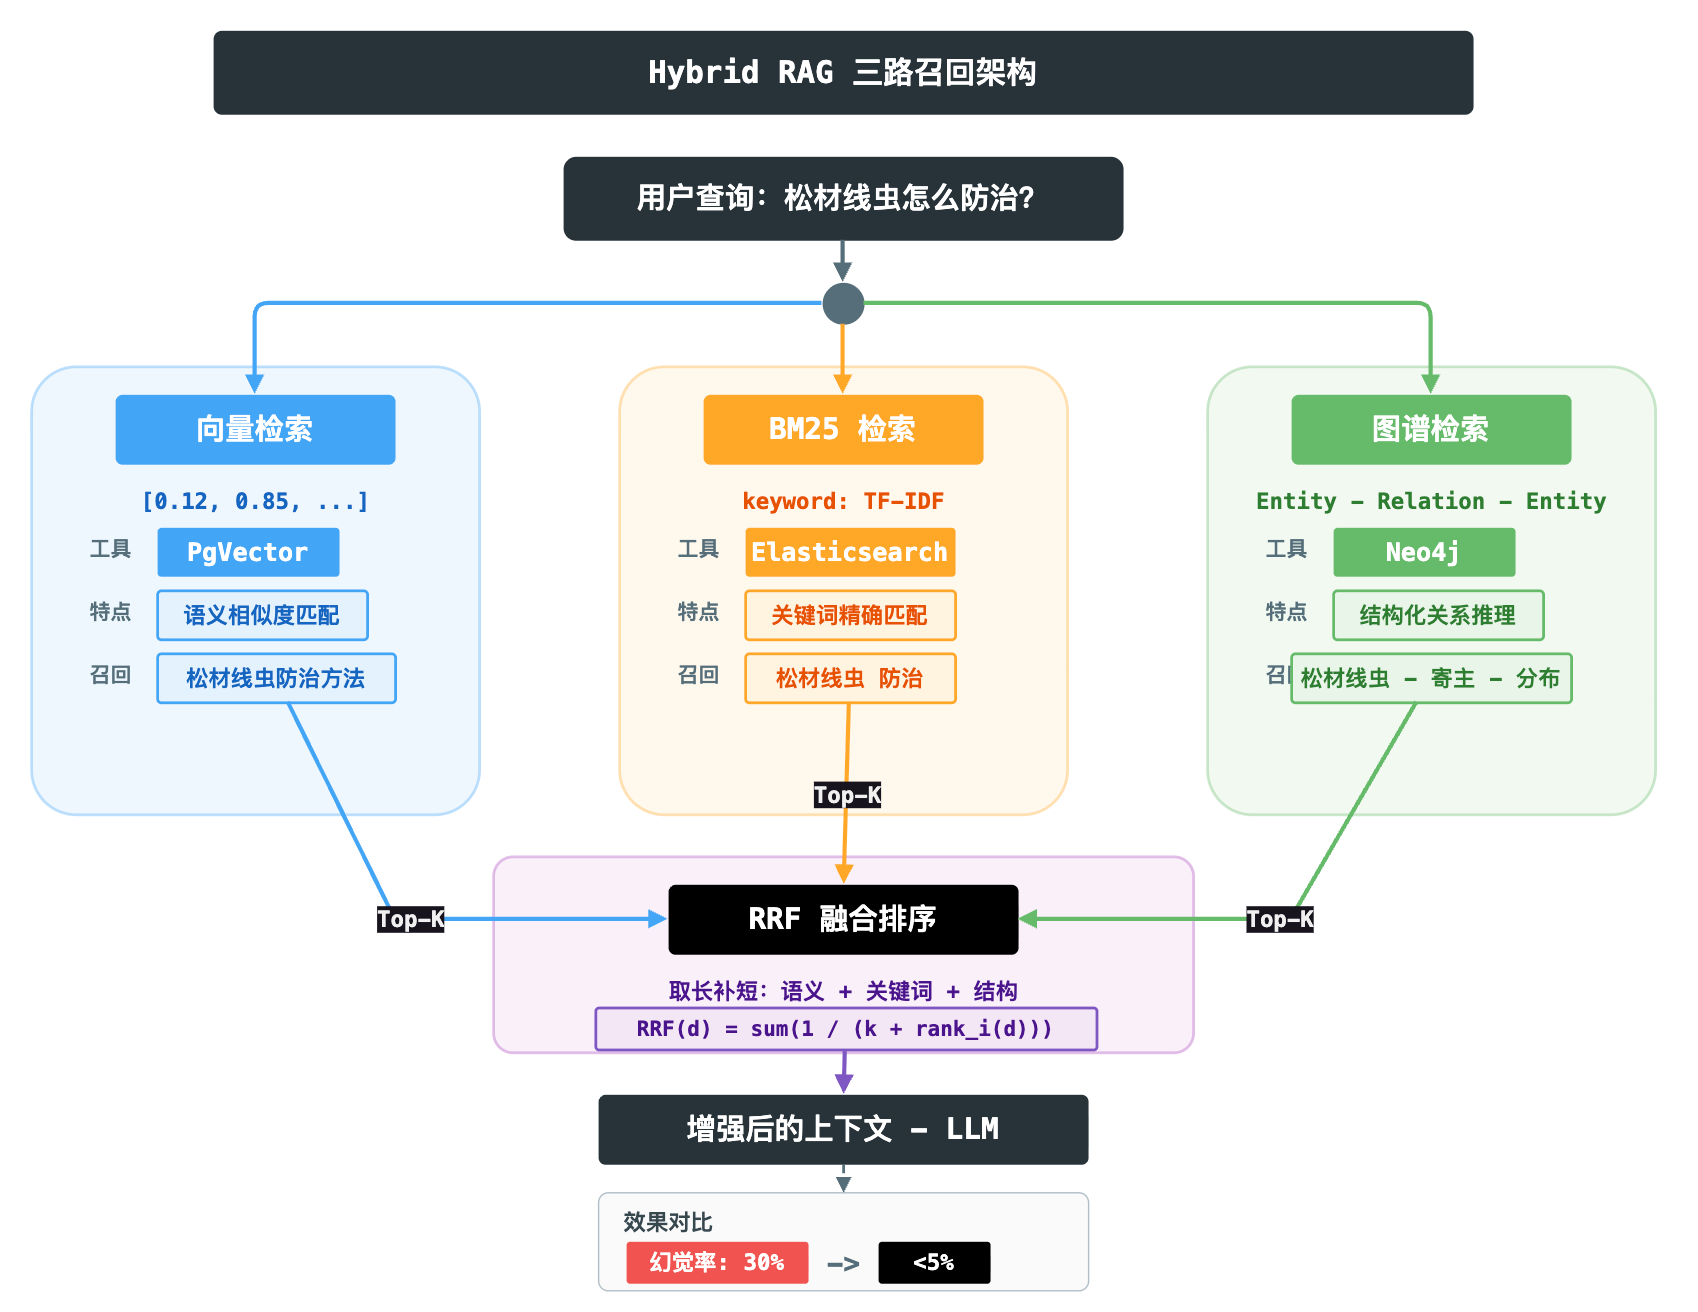
我们的 Hybrid RAG 策略:
- 向量检索(PgVector):语义相似
- BM25 检索:关键词精确匹配
- 图谱检索(Neo4j):结构化关系
三路结果用 RRF(Reciprocal Rank Fusion)算法融合排序,取长补短。
效果:AI 幻觉率从 ~30% 降到 <5%。
图谱如何减少 AI 幻觉?
这可能是面试官最爱追问的问题。
LLM 是概率模型,它会「猜」。知识图谱是事实数据库,它「知道」。图谱提供「锚点」,把 LLM 的生成锚定在真实知识上。
怎么做的?
用户问「杨树天牛分布在哪里?」
先图谱查询:
1 | MATCH (s:Species {name: '杨树天牛'})-[:DISTRIBUTED_IN]->(l:Location) |
返回:['东北', '华北', '西北']
然后构建约束 Prompt:
杨树天牛的分布区域仅限于:东北、华北、西北。请基于这些真实数据回答,不要编造其他地区。
LLM 收到这个 Prompt 后,生成就被「锚定」了。它不会凭空说「华南地区也有」,因为 Prompt 里没有。
概率模型 + 确定性事实 = 可控的生成。
实战代码片段
多跳查询:华东地区松树上的病虫害
1 | // 同时匹配寄主和分布两个条件 |
这条 Cypher 一行搞定,SQL 得四表联查。
查询病虫害的完整知识网络
1 | MATCH (s:Species {name: '松材线虫'}) |
一次性把物种的分类、分布、寄主、文献全拉出来,扔给 LLM 当上下文。
碎碎念
知识图谱这东西,听起来高大上,做起来全是脏活累活。
数据采集、清洗、实体抽取、关系抽取、入库、验证…每一步都有坑。但正因为这些坑,才有了实战的价值。
面试官问「图谱怎么构建的」,你如果只说「用 Neo4j」,大概率被追问到哑口。但如果你说「Scrapy 爬虫采集 → Pandas 清洗 → 规则 + NLP 抽取 → Cypher 批量入库」,还能说出每一步的坑和解决方案,那就不一样了。
技术不在于会不会,在于踩过多少坑。
一句话总结
知识图谱的核心价值就三点:多跳推理、RAG 增强、幻觉约束。面试被问到,就往这三点上靠,准没错。